
Radica ogni risposta la tua conoscenza.
Seleziona un'architettura di recupero, configurane i modelli e i limiti di ricerca, quindi indicizza i documenti che dovrebbero fornire risposte.
Ogni RAG richiede un nome, un modello di incorporamento e una dimensione vettoriale. I modelli di grafico, router, visione e sintesi vengono visualizzati solo quando le relative funzionalità sono abilitate.
Panoramica
Costruisci una pipeline di recupero
Una configurazione RAG converte i documenti di origine in vettori e recupera il contesto rilevante per ogni query. I modelli più avanzati aggiungono riclassificazione, estrazione visiva, attraversamento del grafico, ricerca lessicale o routing basato sugli intenti.
Scegli la strategia di recupero in base alla forma della tua conoscenza.
Seleziona modelli, dimensioni vettoriali e parametri di recupero limitato.
Carica documenti, attendi l'indicizzazione e controlla il recupero con query reali.
Step 01
Seleziona un modello RAG
Ogni modello attiva un percorso di recupero diverso ed espone solo il modello pertinente e i controlli di ottimizzazione nel passaggio due.
Ricerca diretta di incorporamento semantico seguita dalla generazione di risposte fondate.
Recupera un ampio pool di candidati, quindi applica la riclassificazione neurale per mantenere i passaggi più forti.
Combina il recupero del testo con le descrizioni estratte da immagini, grafici e diagrammi.
Estrae entità e relazioni, quindi attraversa un grafico della conoscenza per un contesto multi-hop.
Unisce una densa somiglianza vettoriale con una corrispondenza sparsa di parole chiave BM25 per un richiamo bilanciato.
Classifica ogni query e la instrada tra ricerca vettoriale, attraversamento del grafico o risposta diretta.
Step 02 · Section 01
RAG Dettagli
Identificare la base di conoscenza e descrivere il dominio coperto dalle sue fonti indicizzate.
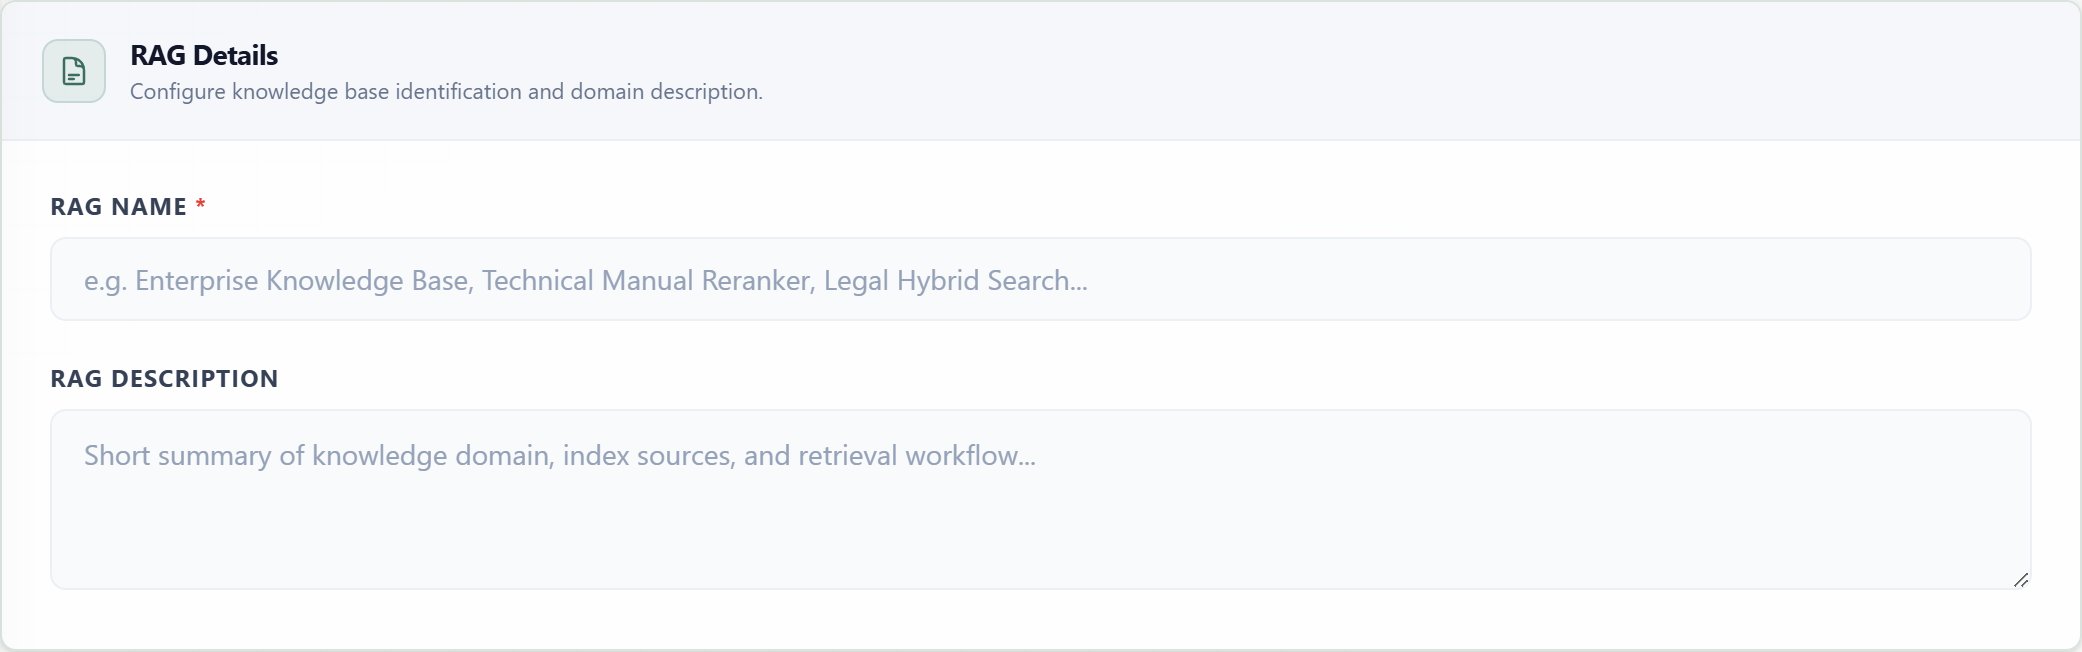
RAG NomeDOCS.NECESSARIAIl nome visualizzato utilizzato nelle directory e nei selettori RAG per agenti, widget e destinazioni API.
DescrizioneDOCS.OPZIONALEUn riassunto conciso del dominio della conoscenza, del materiale di partenza e dello scopo del recupero.
Step 02 · Section 02
Modello di incorporamento vettoriale
Il modello di incorporamento converte porzioni di documento e query in vettori numerici. La dimensione selezionata fissa la forma vettoriale utilizzata per l'indicizzazione e la ricerca di similarità.
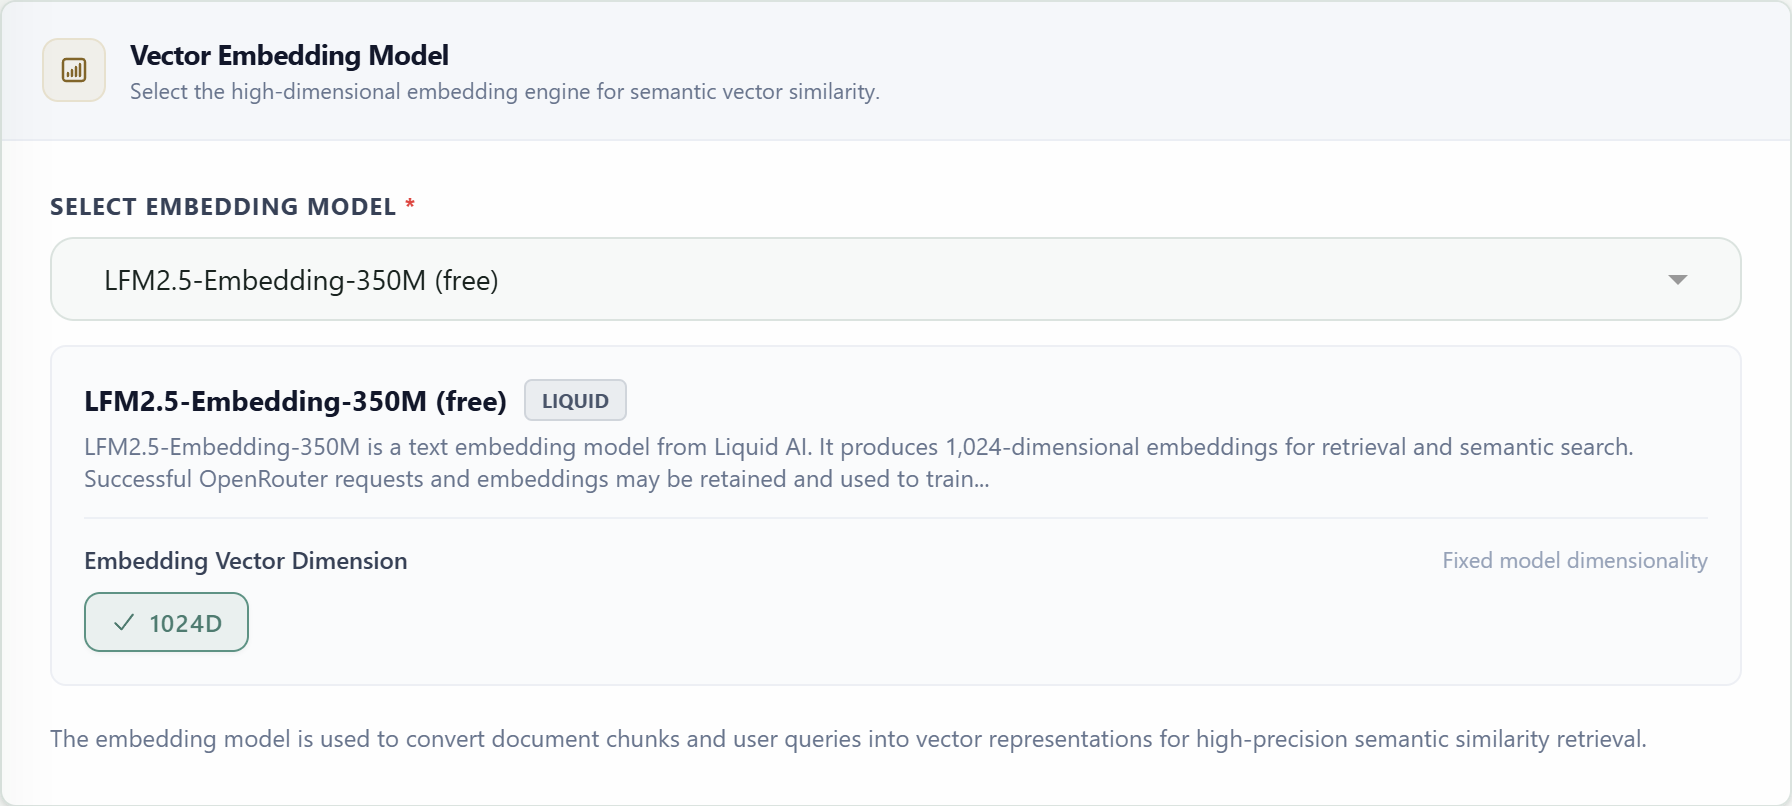
Modello di incorporamentoNecessariaSeleziona il modello di provider utilizzato per codificare sia i blocchi di documenti che le query in entrata.
Dimensione vettorialeNecessariaImposta il numero di valori numerici memorizzati per ciascuna rappresentazione vettoriale.
Step 02 · Section 03
Modello AI di reranking
Il modello di reranking applica un cross-encoder neurale per valutare ogni passaggio candidato rispetto alla query dell'utente dopo un'ampia ricerca vettoriale. Riordina i candidati affinché il contesto finale mantenga i passaggi più pertinenti.
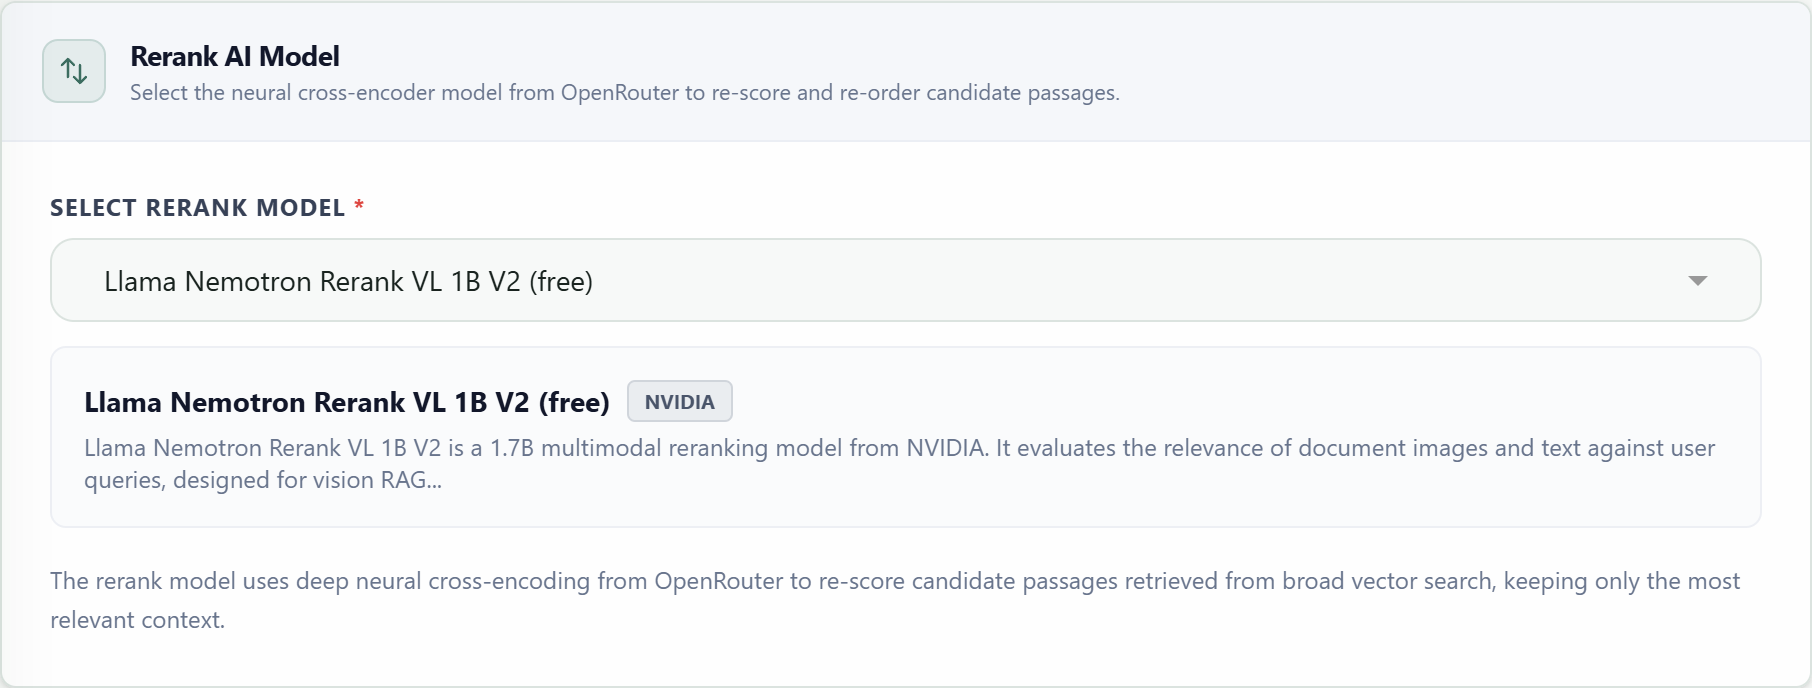
Modello di rerankingNecessariaSeleziona il cross-encoder utilizzato per valutare i candidati della ricerca vettoriale rispetto a ogni query.
Step 02 · Sections 04–07
Modelli AI specializzati
I modelli aggiuntivi vengono visualizzati solo quando l'architettura o una funzionalità opzionale li richiedono. Ogni modello di ragionamento compatibile può anche esporre un selettore di sforzo dopo la selezione.
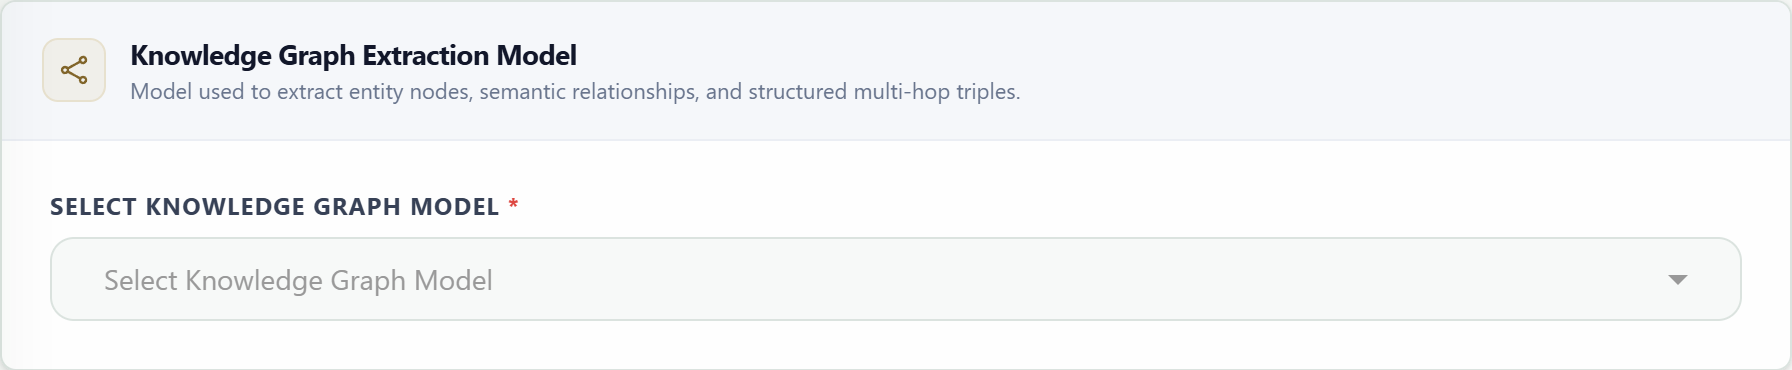
Modello graficoCondizionaleEstrae nodi di entità, relazioni semantiche e triple strutturate durante l'indicizzazione.
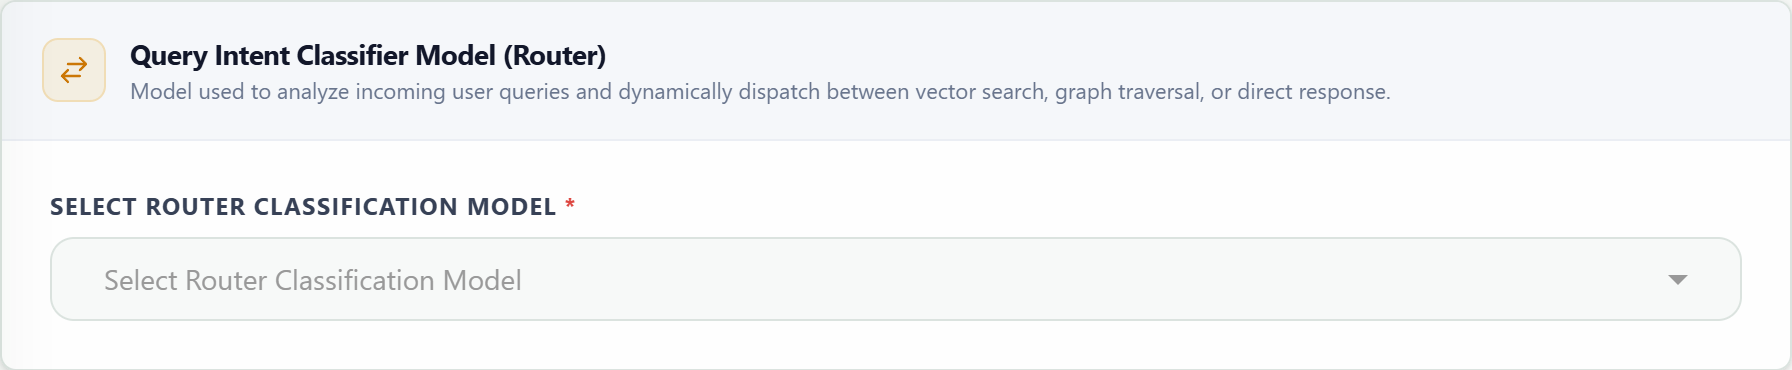
Modello del routerCondizionaleClassifica l'intento in entrata e seleziona il recupero del vettore, l'attraversamento del grafico o la risposta diretta.
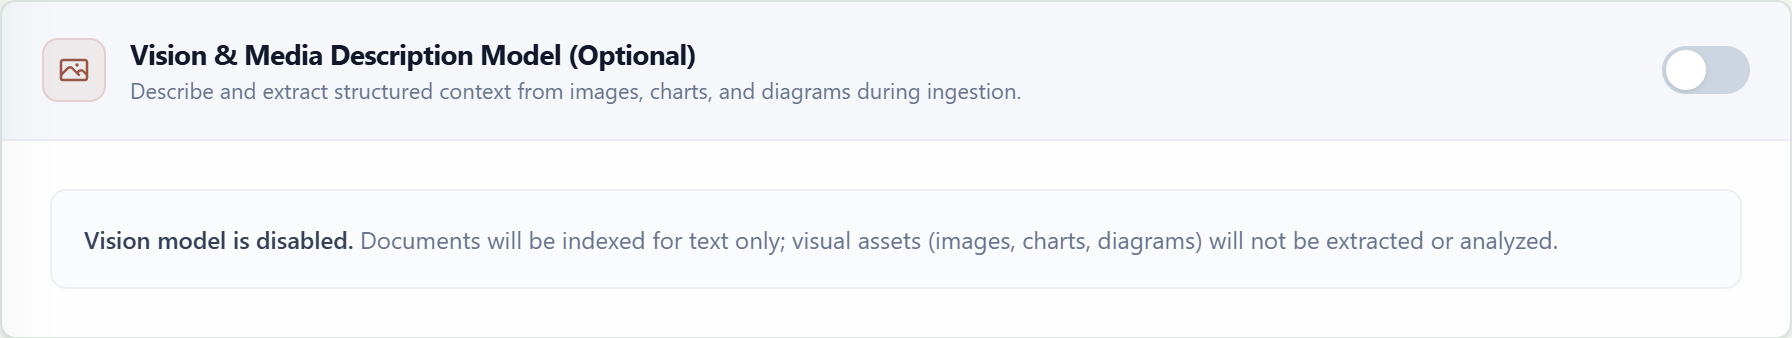
Modello di visioneCondizionaleDescrive immagini, grafici e diagrammi in modo che le informazioni visive possano unirsi al contesto ricercabile.
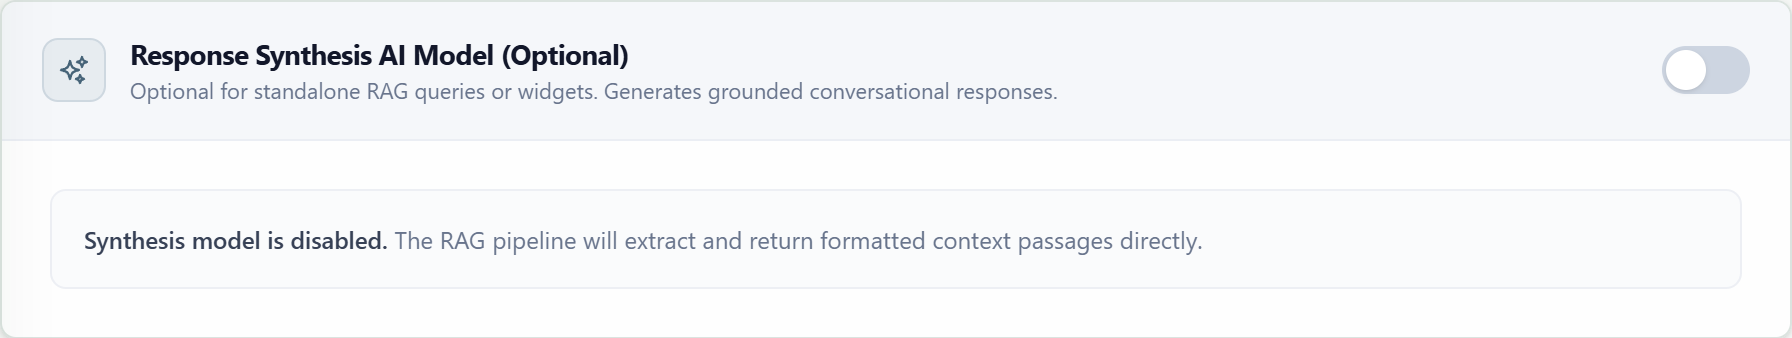
Modello di rispostaCondizionaleTrasforma i passaggi recuperati in una risposta conversazionale fondata per query e widget RAG autonomi.
Sforzo di ragionamentoCondizionaleApplica un livello di impegno supportato ai modelli di grafico, router, visione o risposta.
TemperaturaCondizionaleControlla la variazione nell'output generato per le fasi generative applicabili.
Step 02 · Section 08
Architettura e parametri di recupero
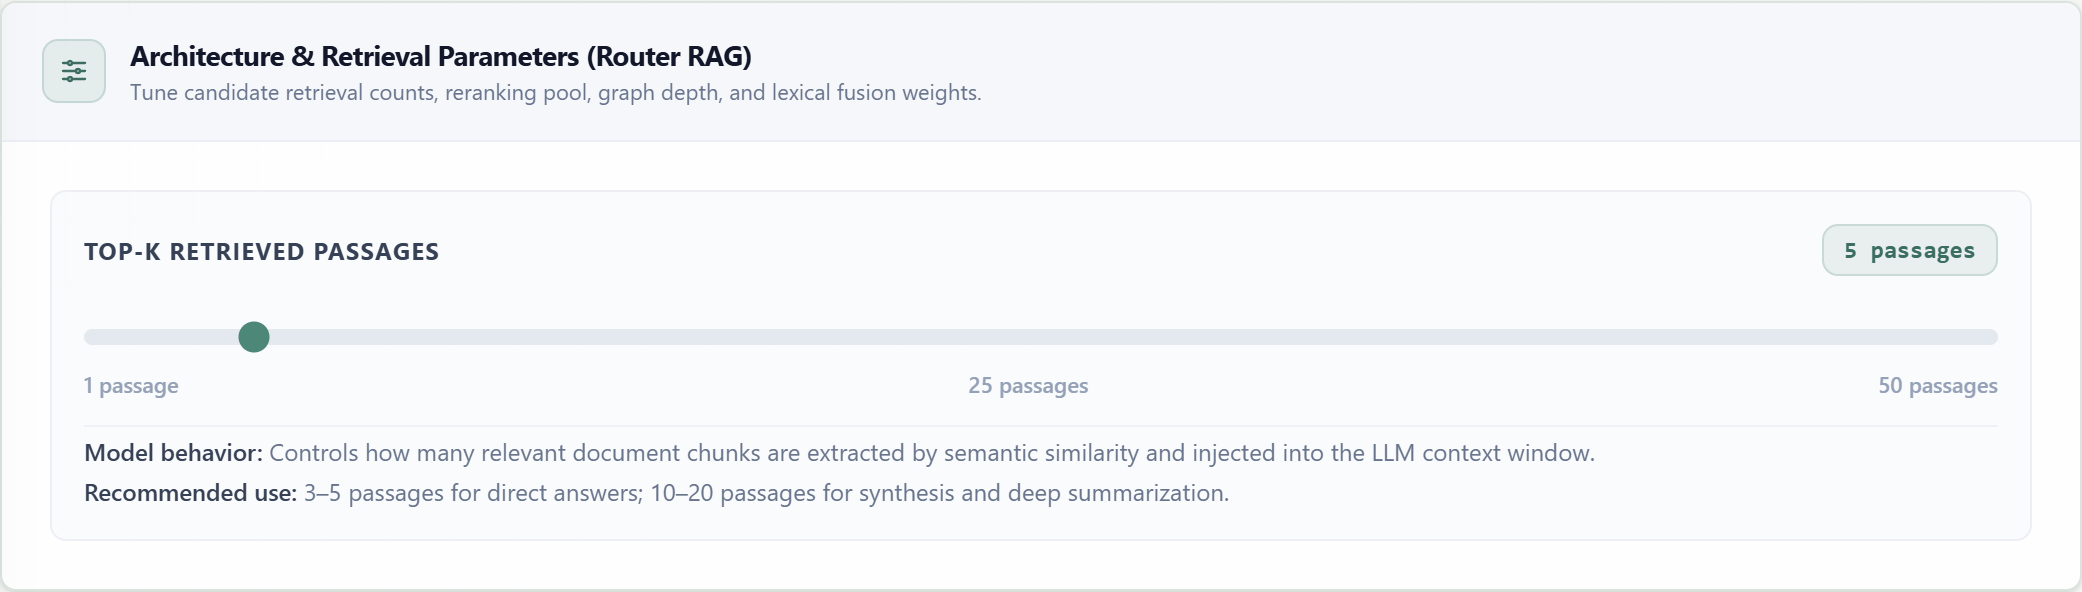
I dispositivi di scorrimento controllano la quantità di contesto candidato raccolto in ogni fase. La scheda cambia con il modello selezionato, quindi vengono visualizzati solo i parametri utilizzati da quella pipeline.
| Parametro | Modella | Predefinito/Intervallo | Scopo |
|---|---|---|---|
| top_k | Ingenuo, Multimodale, Router | 5 · 1–50 | Passaggi inseriti nel contesto finale. |
| iniziale_top_k | Recupera e riclassifica | 25 · 5–100 | Ampio pool di candidati semantici prima della riclassificazione. |
| final_top_k | Riclassifica, ibrido | 5 · 1–20 | Passaggi mantenuti dopo la riclassificazione o la fusione dei ranghi. |
| vettore_top_k | Grafico | 4 · 1–20 | Pezzi seme semantici utilizzati per individuare le entità del grafico. |
| grafico_profondità | Grafico | 1 · 1–3 | Salti di relazione attraversati dalle entità seme. |
| grafico_limit | Grafico | 20 · 1–100 | Il numero massimo di triple di relazione entità aggiunte al contesto. |
| vettore_k | Ibrida | 15 · 1–50 | Candidati semantici densi inclusi nella fusione dei ranghi. |
| bm25_k | Ibrida | 15 · 1–50 | Candidati lessicali sparsi inclusi nella fusione dei ranghi. |
Step 02 · Section 08
Documenti della base di conoscenza
Salvare prima RAG per abilitare il caricamento dei documenti. I file caricati vengono indicizzati con il modello di incorporamento selezionato e diventano disponibili per il recupero al termine dell'elaborazione.
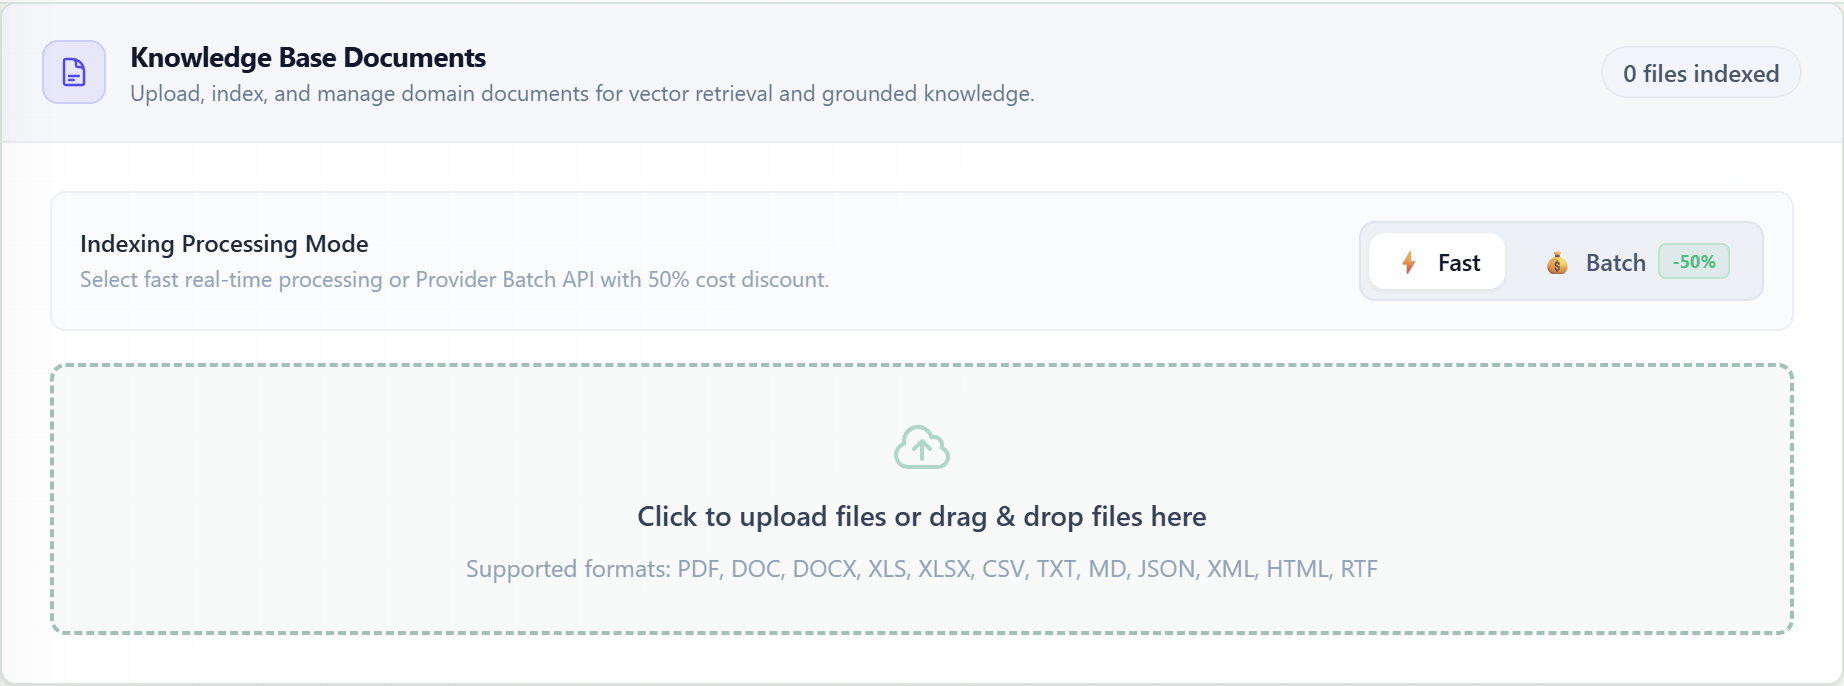
La modifica del modello di incorporamento o della dimensione del vettore dopo l'indicizzazione può richiedere la rielaborazione dei documenti in modo che i vettori archiviati rimangano compatibili.
Step 02 · Section 09
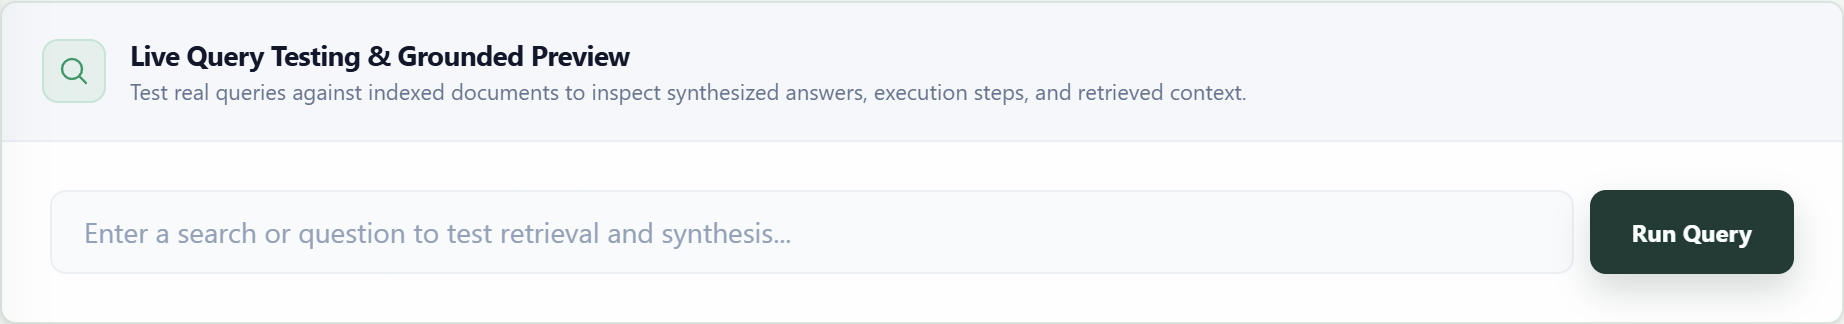
Test di query in tempo reale
Dopo aver salvato e indicizzato i documenti, inviare query rappresentative per esaminare la risposta fondata, i blocchi recuperati, i fatti estratti, le fasi di esecuzione e il contesto assemblato.
Obbligatorio prima del salvataggio
Modello, nome RAG, modello di incorporamento, dimensione vettoriale e ogni modello richiesto dall'architettura selezionata.
Dopo la creazione
Utilizza domande che richiedono fatti esatti e sintesi da più fonti, quindi regola i limiti di recupero in base alle prove restituite.