
Aard elk antwoord jouw kennis.
Selecteer een ophaalarchitectuur, configureer de modellen en zoeklimieten ervan en indexeer vervolgens de documenten die antwoorden moeten verzamelen.
Elke RAG vereist een naam, een inbeddingsmodel en een vectordimensie. Grafiek-, router-, vision- en synthesemodellen verschijnen alleen als hun mogelijkheden zijn ingeschakeld.
Overzicht
Bouw een ophaalpijplijn
Een RAG-configuratie converteert brondocumenten naar vectoren en haalt voor elke zoekopdracht de relevante context op. Meer geavanceerde patronen omvatten herschikking, visuele extractie, grafiekdoorloop, lexicaal zoeken of op intentie gebaseerde routering.
Kies de vindstrategie die past bij de vorm van uw kennis.
Selecteer modellen, vectorafmetingen en begrensde ophaalparameters.
Upload documenten, wacht op indexering en inspecteer het ophalen met echte zoekopdrachten.
Step 01
Selecteer een RAG-patroon
Elk patroon activeert een ander ophaalpad en geeft in stap twee alleen het relevante model en de afstemmingsknoppen weer.
Direct zoeken naar semantische inbedding, gevolgd door het genereren van gegronde antwoorden.
Haalt een brede kandidatenpool op en past vervolgens neurale herschikking toe om de sterkste passages te behouden.
Combineert het ophalen van tekst met beschrijvingen uit afbeeldingen, grafieken en diagrammen.
Extraheert entiteiten en relaties en doorloopt vervolgens een kennisgrafiek voor multi-hop-context.
Combineert een dichte vectorovereenkomst met spaarzame BM25-trefwoordmatching voor een evenwichtige herinnering.
Classificeert elke zoekopdracht en routeert deze tussen vectorzoekopdracht, grafiekdoorgang of directe respons.
Step 02 · Section 01
RAG-details
Identificeer de kennisbank en beschrijf het domein dat door de geïndexeerde bronnen wordt bestreken.
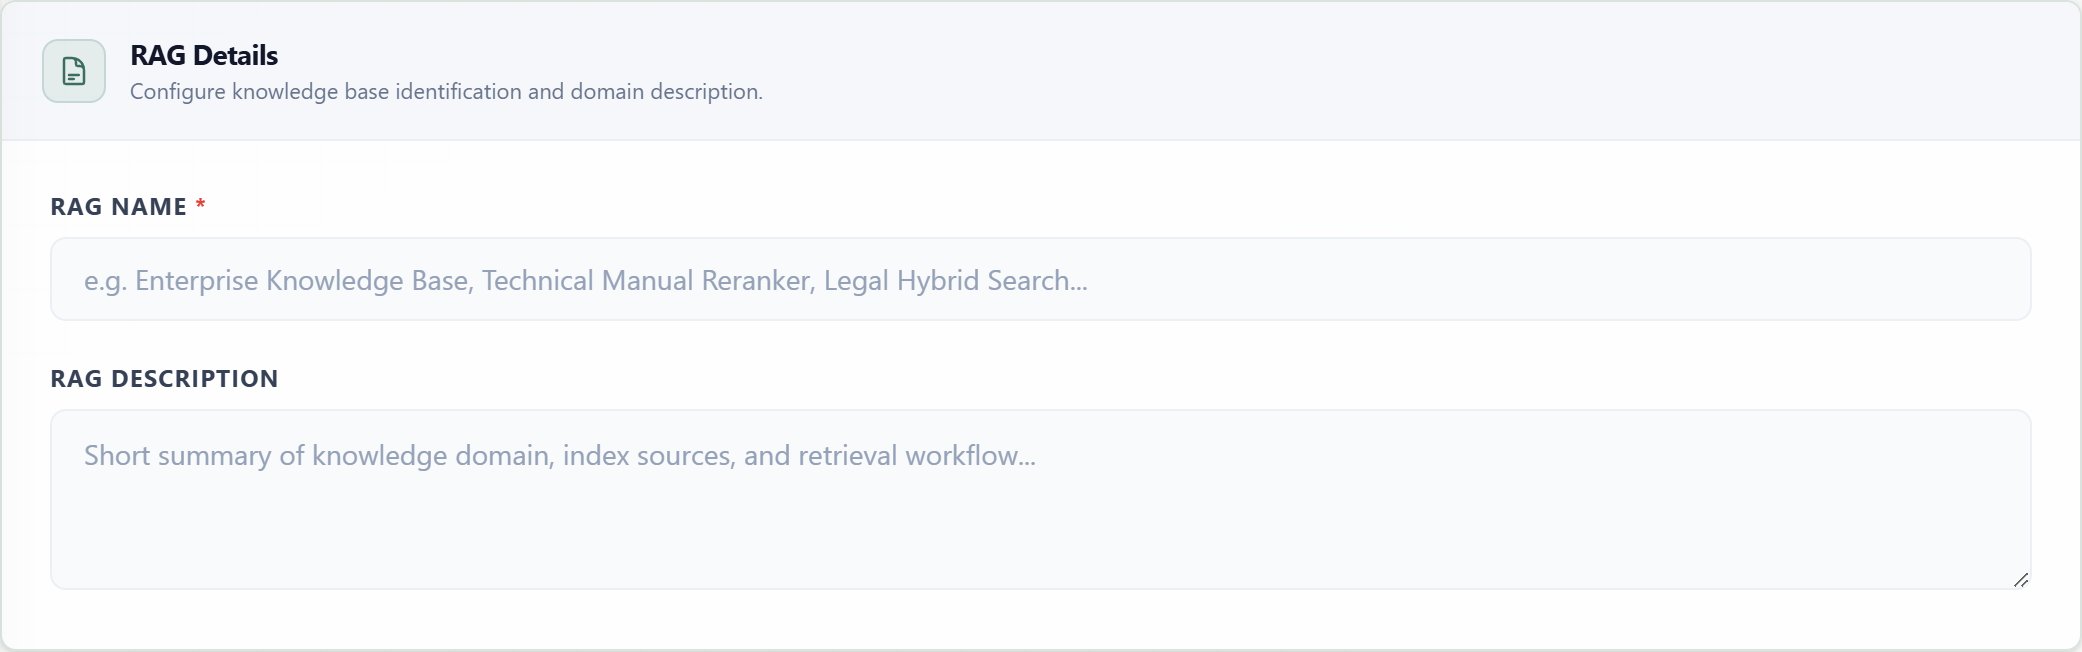
RAG NaamDOCS.VEREISTDe weergavenaam die wordt gebruikt in RAG-directory's en selectors voor agenten, widgets en API-doelen.
BeschrijvingDOCS.OPTIONEELEen beknopte samenvatting van het kennisdomein, het bronmateriaal en het ontsluitingsdoel.
Step 02 · Section 02
Vector-inbeddingsmodel
Het inbeddingsmodel converteert documentfragmenten en query's naar numerieke vectoren. De geselecteerde dimensie legt de vectorvorm vast die wordt gebruikt voor indexering en zoeken naar gelijkenissen.
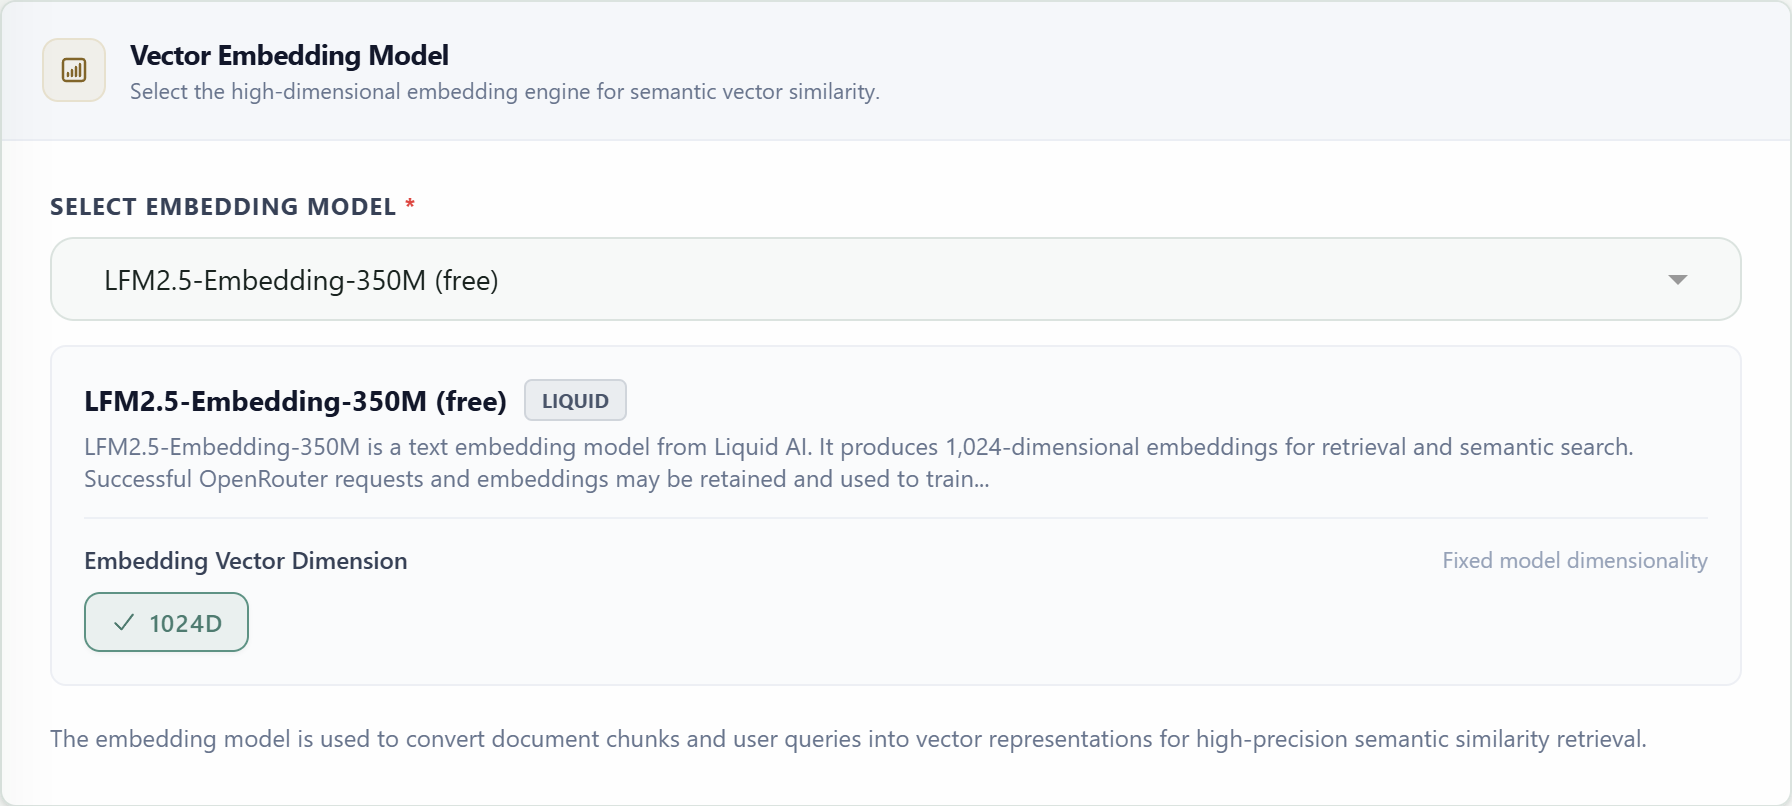
InbeddingsmodelVereistSelecteert het providermodel dat wordt gebruikt om zowel documentfragmenten als inkomende query's te coderen.
VectordimensieVereistStelt het aantal numerieke waarden in dat voor elke vectorrepresentatie is opgeslagen.
Step 02 · Section 03
AI-rerankmodel
Het rerankmodel gebruikt een neurale cross-encoder om na brede vectorzoekopdrachten elk kandidaatfragment te beoordelen op relevantie voor de gebruikersvraag. Het rangschikt de kandidaten opnieuw, zodat de uiteindelijke context de meest relevante fragmenten bevat.
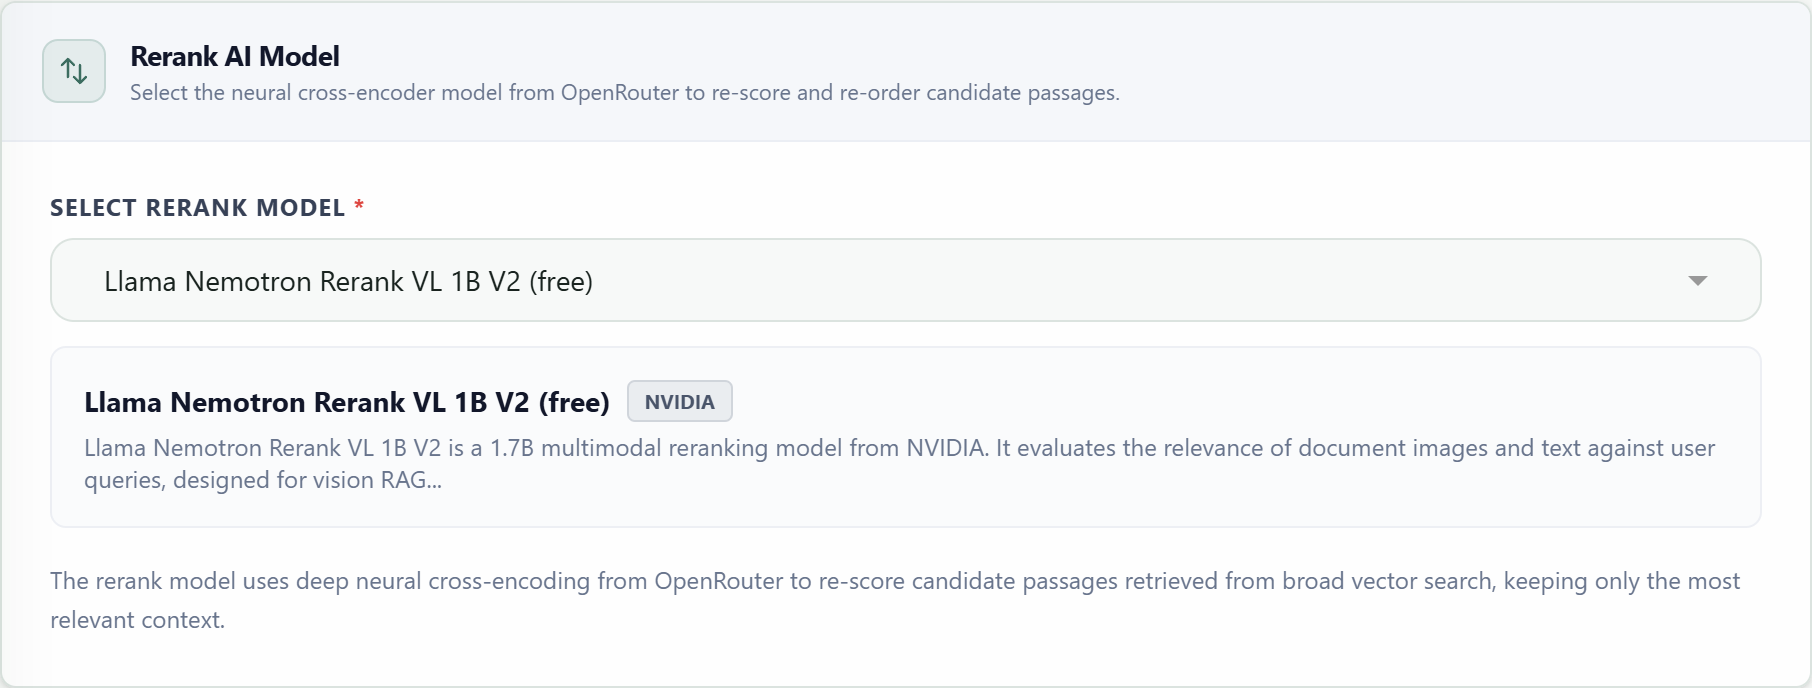
RerankmodelVereistSelecteert de cross-encoder die kandidaten uit de vectorzoekopdracht beoordeelt op basis van elke vraag.
Step 02 · Sections 04–07
Gespecialiseerde AI-modellen
Extra modellen verschijnen alleen wanneer de architectuur of een optionele mogelijkheid deze nodig heeft. Elk compatibel redeneermodel kan na selectie ook een inspanningsselector blootleggen.
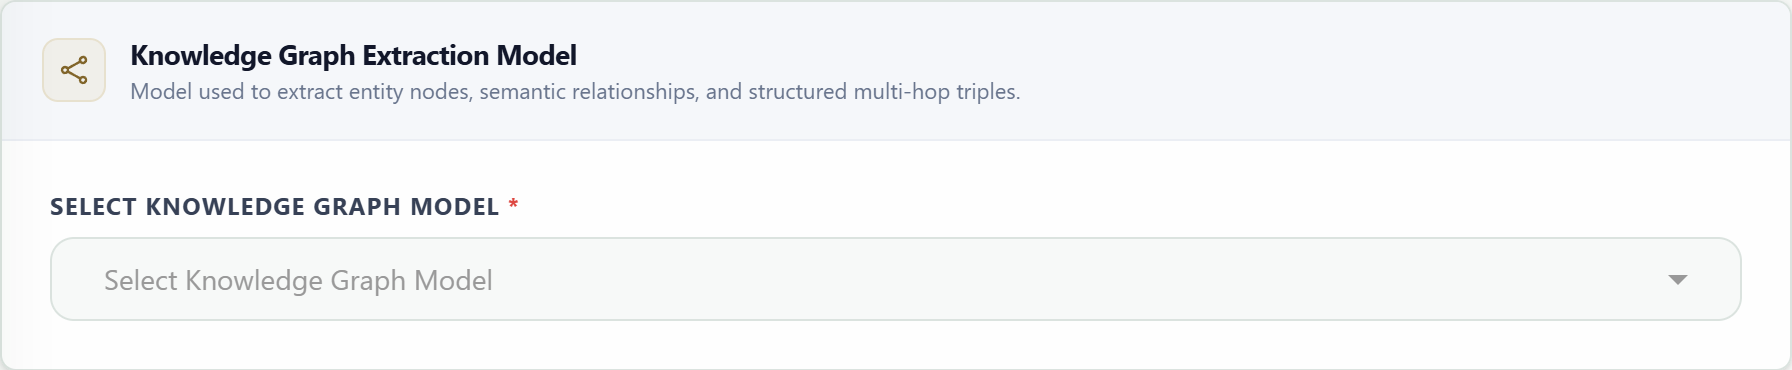
GrafiekmodelVoorwaardelijkExtraheert entiteitsknooppunten, semantische relaties en gestructureerde triples tijdens het indexeren.
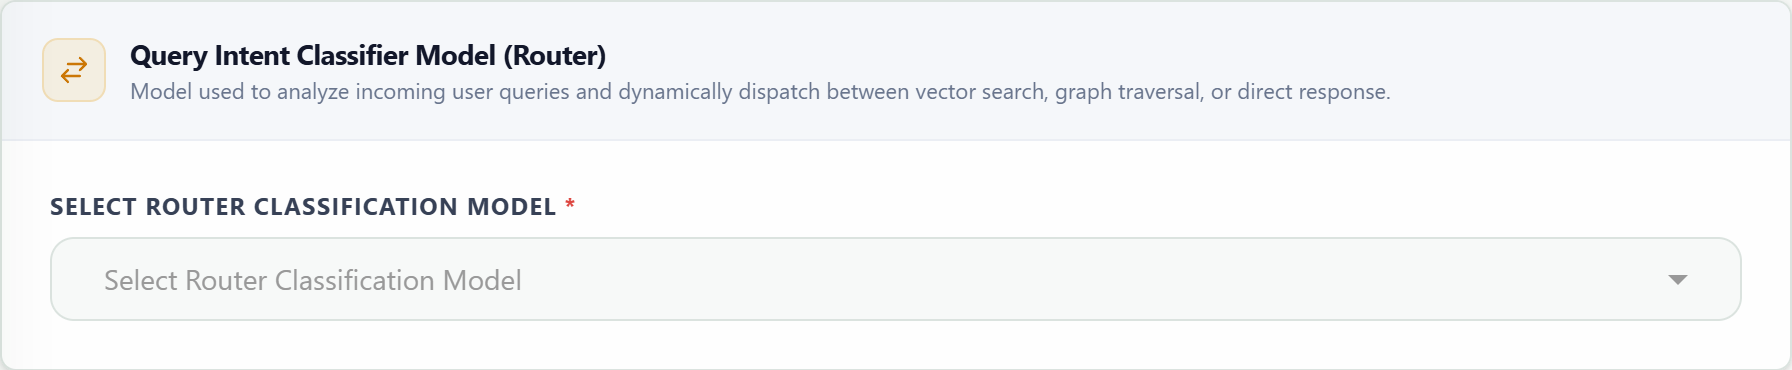
RoutermodelVoorwaardelijkClassificeert inkomende intentie en selecteert vectorherstel, grafiekdoorgang of directe respons.
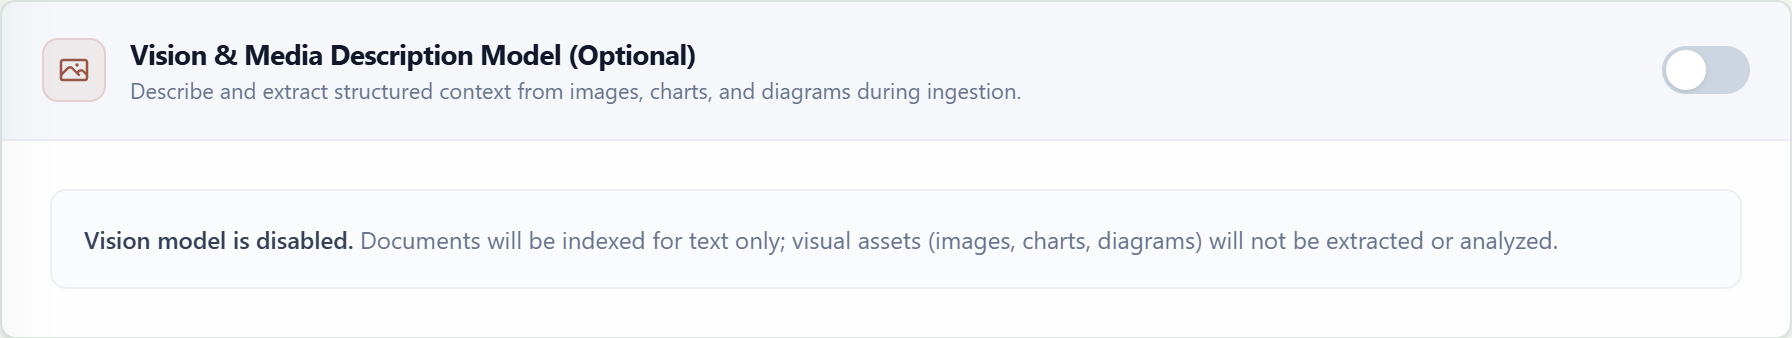
VisiemodelVoorwaardelijkBeschrijft afbeeldingen, grafieken en diagrammen zodat visuele informatie kan worden toegevoegd aan de doorzoekbare context.
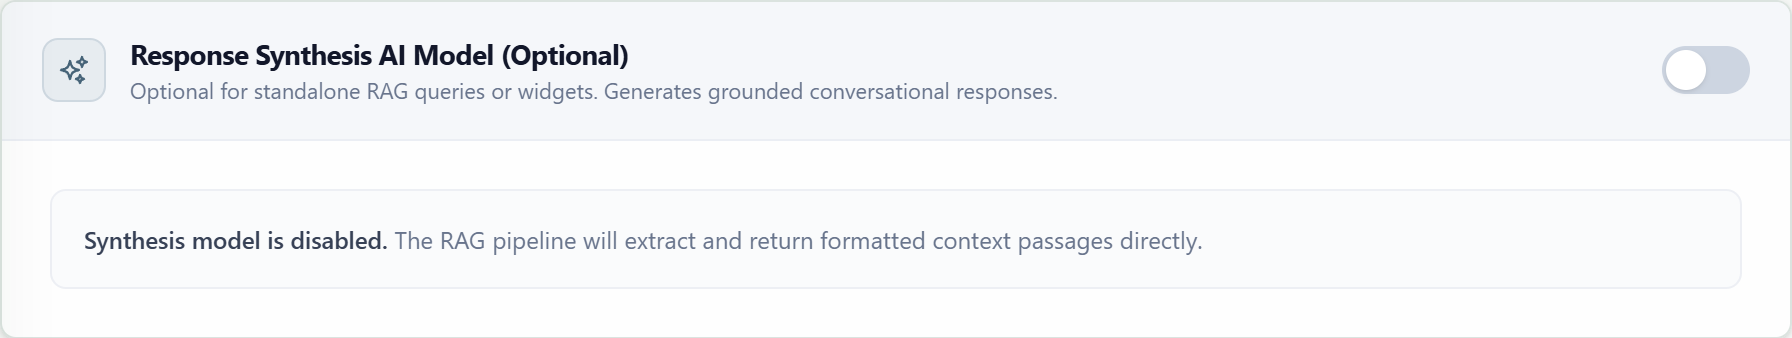
ReactiemodelVoorwaardelijkVerandert opgehaalde passages in een gefundeerd gespreksantwoord voor zelfstandige RAG-query's en widgets.
Redenerende inspanningVoorwaardelijkPast een ondersteund inspanningsniveau toe op grafiek-, router-, vision- of responsmodellen.
TemperatuurVoorwaardelijkBeheert de variatie in de gegenereerde uitvoer voor toepasselijke generatieve fasen.
Step 02 · Section 08
Architectuur- en ophaalparameters
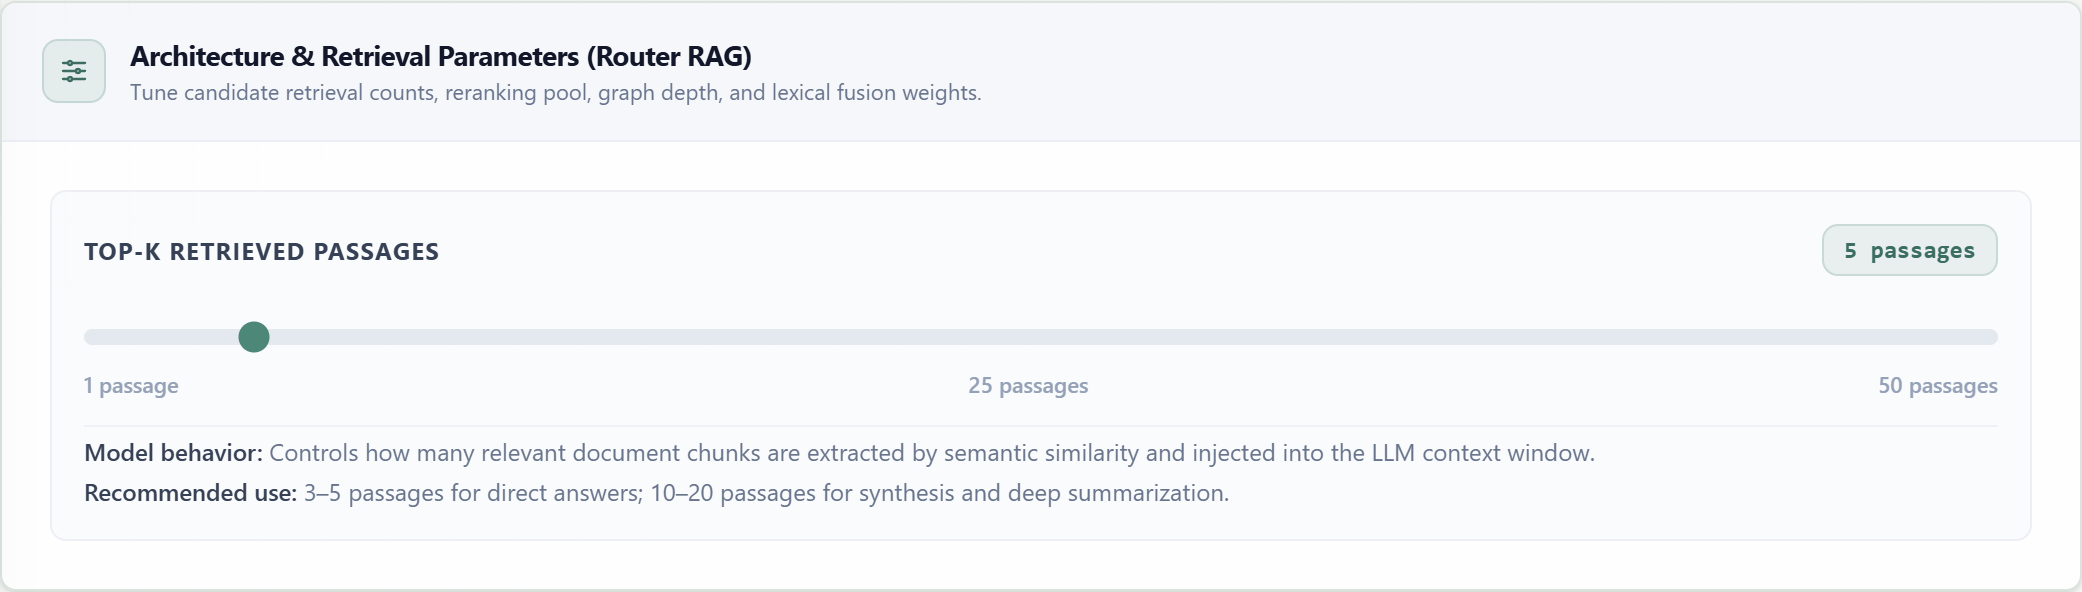
Schuifregelaars bepalen de hoeveelheid kandidaatcontext die in elke fase wordt verzameld. De kaart verandert met het geselecteerde patroon, dus alleen parameters die door die pijplijn worden gebruikt, worden weergegeven.
| Parameter | Patroon | Standaard / Bereik | Doel |
|---|---|---|---|
| top_k | Naïef, multimodaal, router | 5 · 1–50 | Passages geïnjecteerd in de uiteindelijke context. |
| initial_top_k | Ophalen en opnieuw rangschikken | 25 · 5–100 | Brede semantische kandidatenpool vóór herschikking. |
| final_top_k | Herschik, hybride | 5 · 1–20 | Passages behouden na herschikking of rangschikking. |
| vector_top_k | Grafiek | 4 · 1–20 | Semantische zaadblokken die worden gebruikt om grafiekentiteiten te lokaliseren. |
| grafiek_diepte | Grafiek | 1 · 1–3 | Relatie-hops zijn doorkruist vanuit de zaadentiteiten. |
| grafiek_limiet | Grafiek | 20 · 1–100 | Maximale verdrievoudiging van entiteitsrelaties toegevoegd aan context. |
| vector_k | Hybride | 15 · 1–50 | Dichte semantische kandidaten opgenomen in rangfusie. |
| bm25_k | Hybride | 15 · 1–50 | Schaarse lexicale kandidaten opgenomen in rangfusie. |
Step 02 · Section 08
Kennisbankdocumenten
Sla eerst de RAG op om documentuploads mogelijk te maken. Geüploade bestanden worden geïndexeerd met het geselecteerde inbeddingsmodel en kunnen worden opgehaald nadat de verwerking is voltooid.
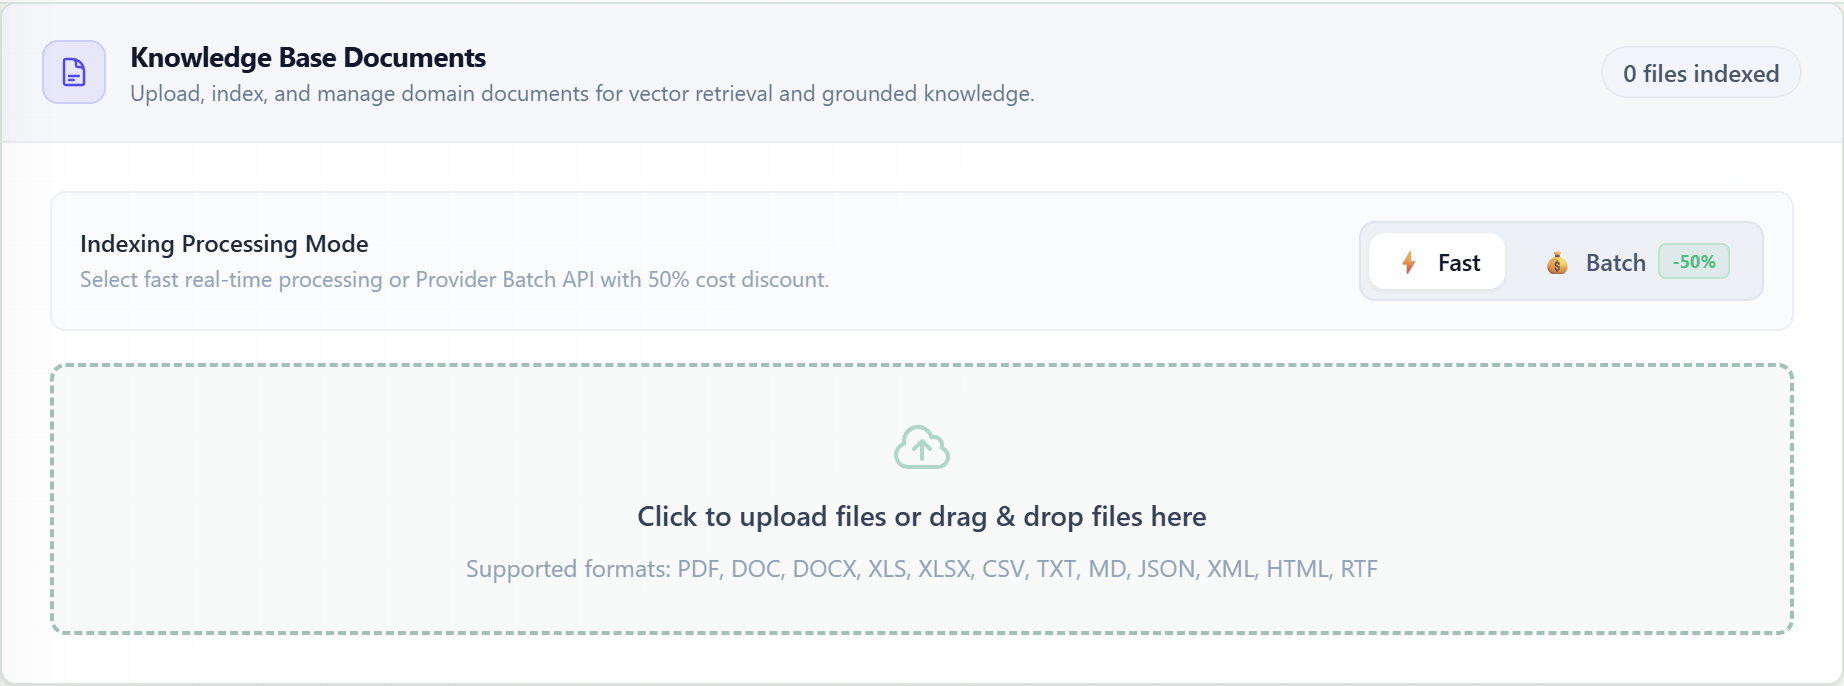
Als u het inbeddingsmodel of de vectordimensie na indexering wijzigt, kan het nodig zijn dat documenten opnieuw worden verwerkt, zodat opgeslagen vectoren compatibel blijven.
Step 02 · Section 09
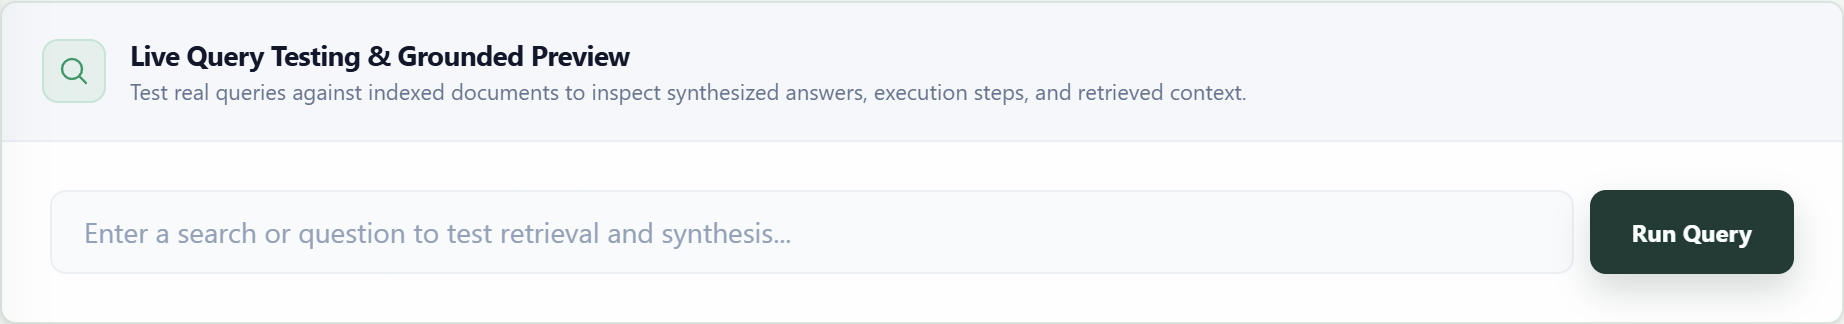
Live query-testen
Na het opslaan en indexeren van documenten kunt u representatieve vragen indienen om het gegronde antwoord, de opgehaalde brokken, de geëxtraheerde feiten, de uitvoeringsstappen en de verzamelde context te inspecteren.
Vereist vóór opslaan
Patroon, RAG-naam, inbeddingsmodel, vectordimensie en elk model dat vereist is voor de geselecteerde architectuur.
Na creatie
Gebruik vragen die exacte feiten en een synthese uit meerdere bronnen vereisen, en pas vervolgens de ophaallimieten aan op basis van het geretourneerde bewijsmateriaal.