
Ancorează fiecare răspuns în cunoștințele tale.
Selectează o arhitectură de regăsire, configurează modelele și limitele de căutare, apoi indexează documentele care trebuie să ancoreze răspunsurile.
Fiecare RAG necesită un nume, un model de embedding și o dimensiune vectorială. Modelele pentru graf, router, viziune și sinteză apar doar când capabilitățile lor sunt activate.
Prezentare
Construiește o conductă de regăsire
O configurație RAG convertește documentele sursă în vectori și regăsește context relevant pentru fiecare interogare. Tiparele avansate adaugă reranking, extragere vizuală, parcurgere de graf, căutare lexicală sau rutare bazată pe intenție.
Alege strategia de regăsire pentru forma cunoștințelor tale.
Selectează modele, dimensiuni vectoriale și parametri de regăsire limitați.
Încarcă documente, așteaptă indexarea și inspectează regăsirea cu interogări reale.
Step 01
Selectează un tipar RAG
Fiecare tipar activează o cale diferită de regăsire și afișează în pasul doi doar modelele și controalele de ajustare relevante.
Căutare semantică directă pe embeddinguri, urmată de generarea unui răspuns ancorat.
Regăsește un grup larg de candidați, apoi aplică reranking neural pentru a păstra pasajele cele mai bune.
Combină regăsirea textului cu descrieri extrase din imagini, grafice și diagrame.
Extrage entități și relații, apoi parcurge un graf de cunoștințe pentru context multi-hop.
Combină similaritatea vectorială densă cu potrivirea rară de cuvinte-cheie BM25 pentru recall echilibrat.
Clasifică fiecare interogare și o rutează între căutare vectorială, parcurgere de graf sau răspuns direct.
Step 02 · Section 01
Detaliile RAG-ului
Identifică baza de cunoștințe și descrie domeniul acoperit de sursele sale indexate.
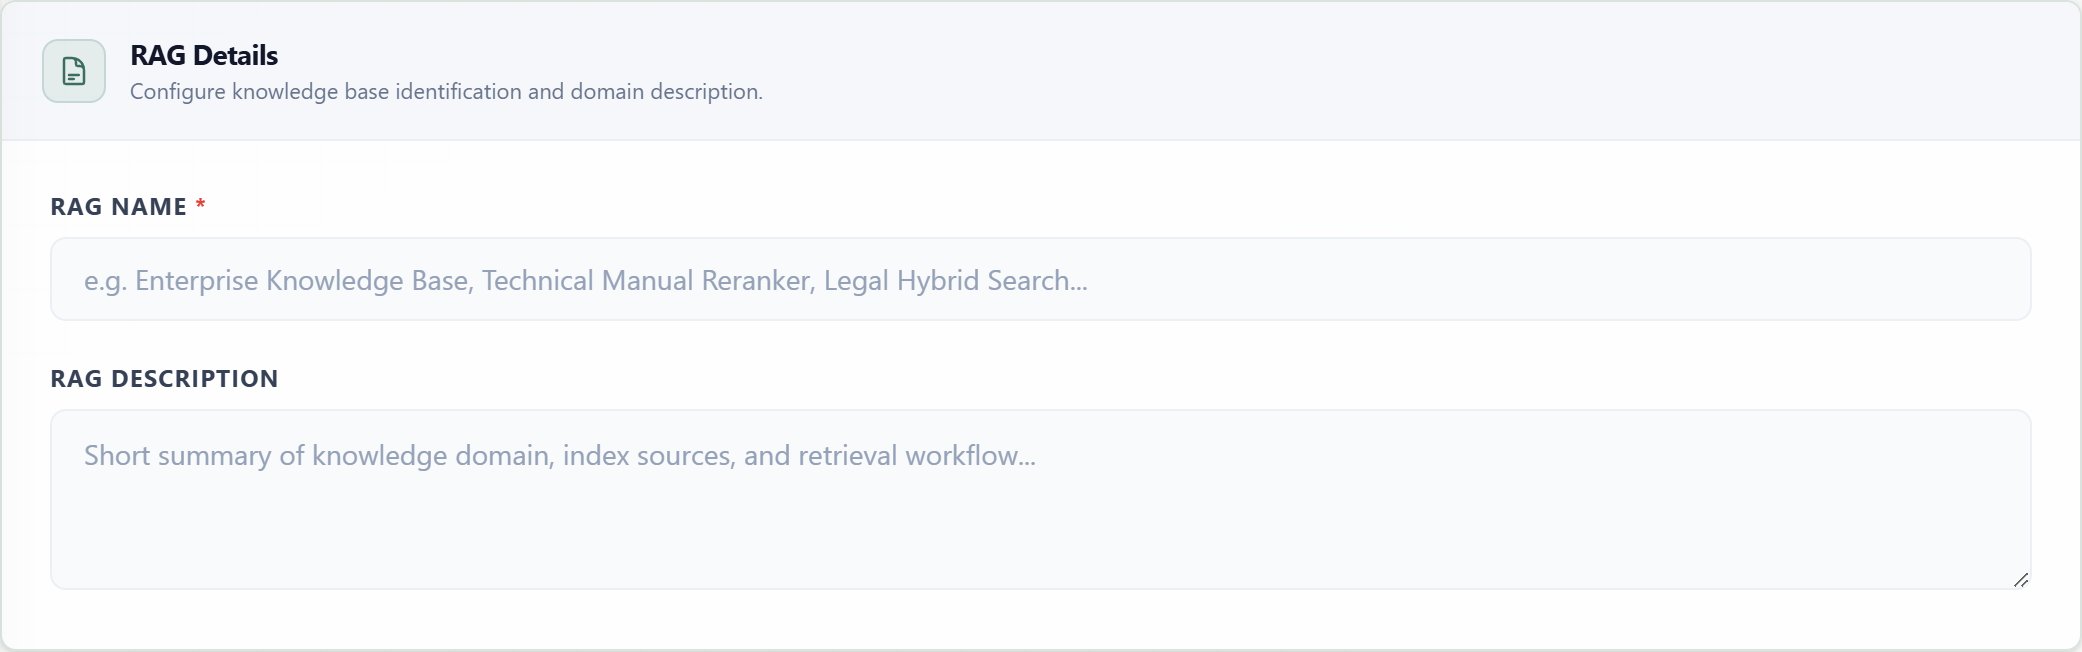
Numele RAG-uluiObligatoriuNumele afișat în directoarele RAG și selectoarele pentru agenți, widgeturi și ținte API.
DescriereOpționalUn rezumat concis al domeniului de cunoștințe, materialului sursă și scopului regăsirii.
Step 02 · Section 02
Modelul de embedding vectorial
Modelul de embedding convertește fragmentele de documente și interogările în vectori numerici. Dimensiunea selectată fixează forma vectorului folosită pentru indexare și căutare după similaritate.
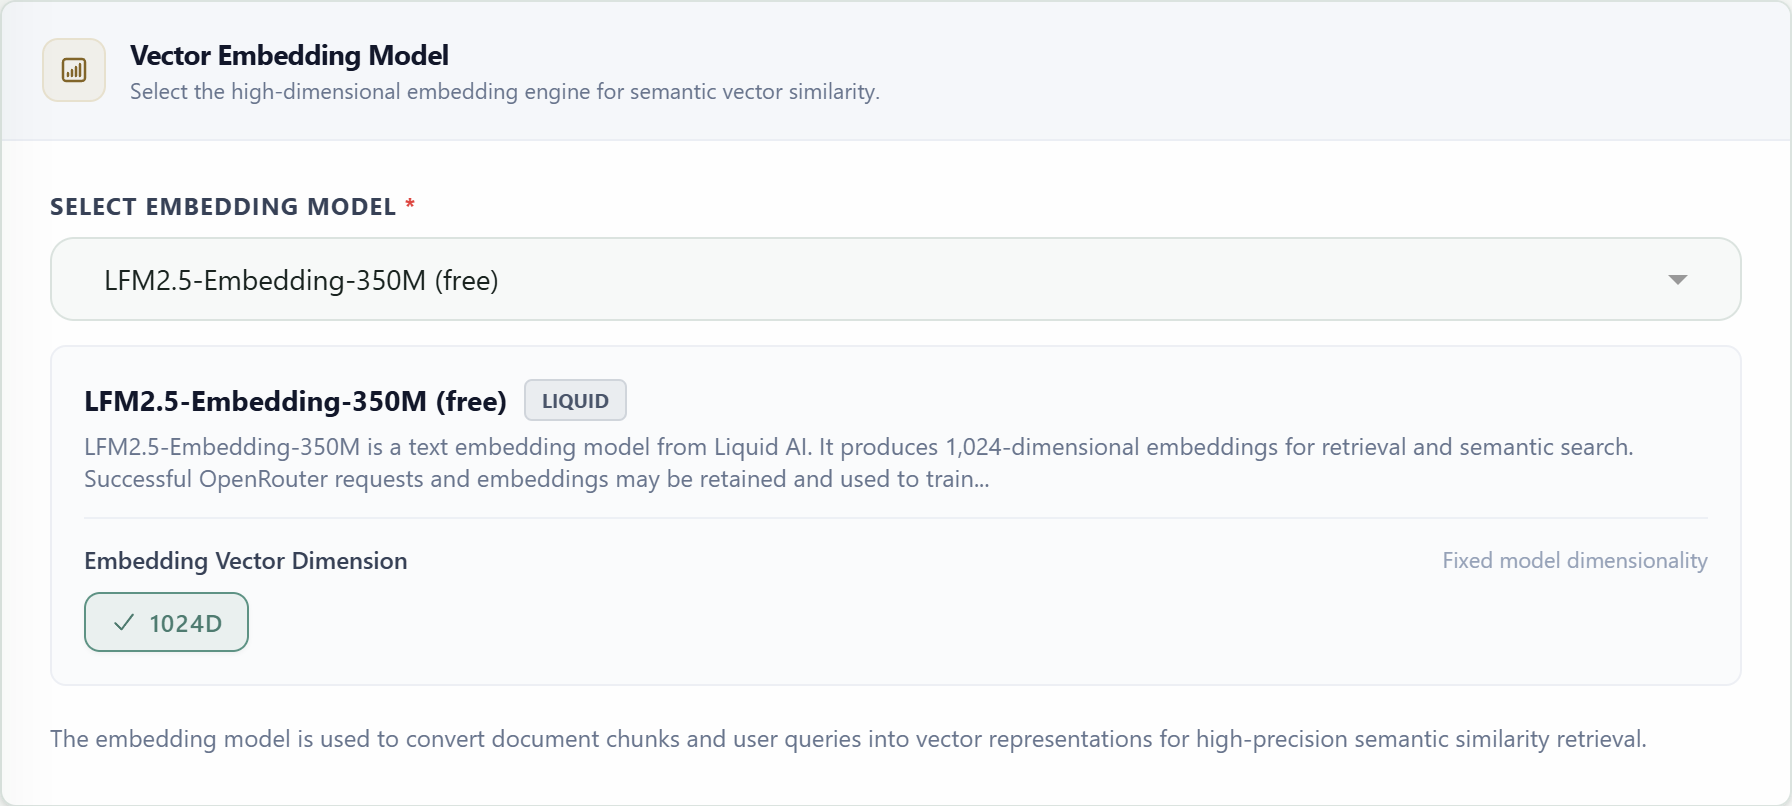
Model de embeddingObligatoriuSelectează modelul furnizorului folosit pentru codificarea fragmentelor de documente și a interogărilor primite.
Dimensiunea vectoruluiObligatoriuStabilește numărul valorilor numerice stocate pentru fiecare reprezentare vectorială.
Step 02 · Section 03
Model AI de reranking
Modelul de reranking folosește un cross-encoder neural pentru a evalua relevanța fiecărui pasaj candidat în raport cu interogarea, după o regăsire vectorială amplă. Reordonează candidații astfel încât contextul final să păstreze pasajele cele mai relevante.
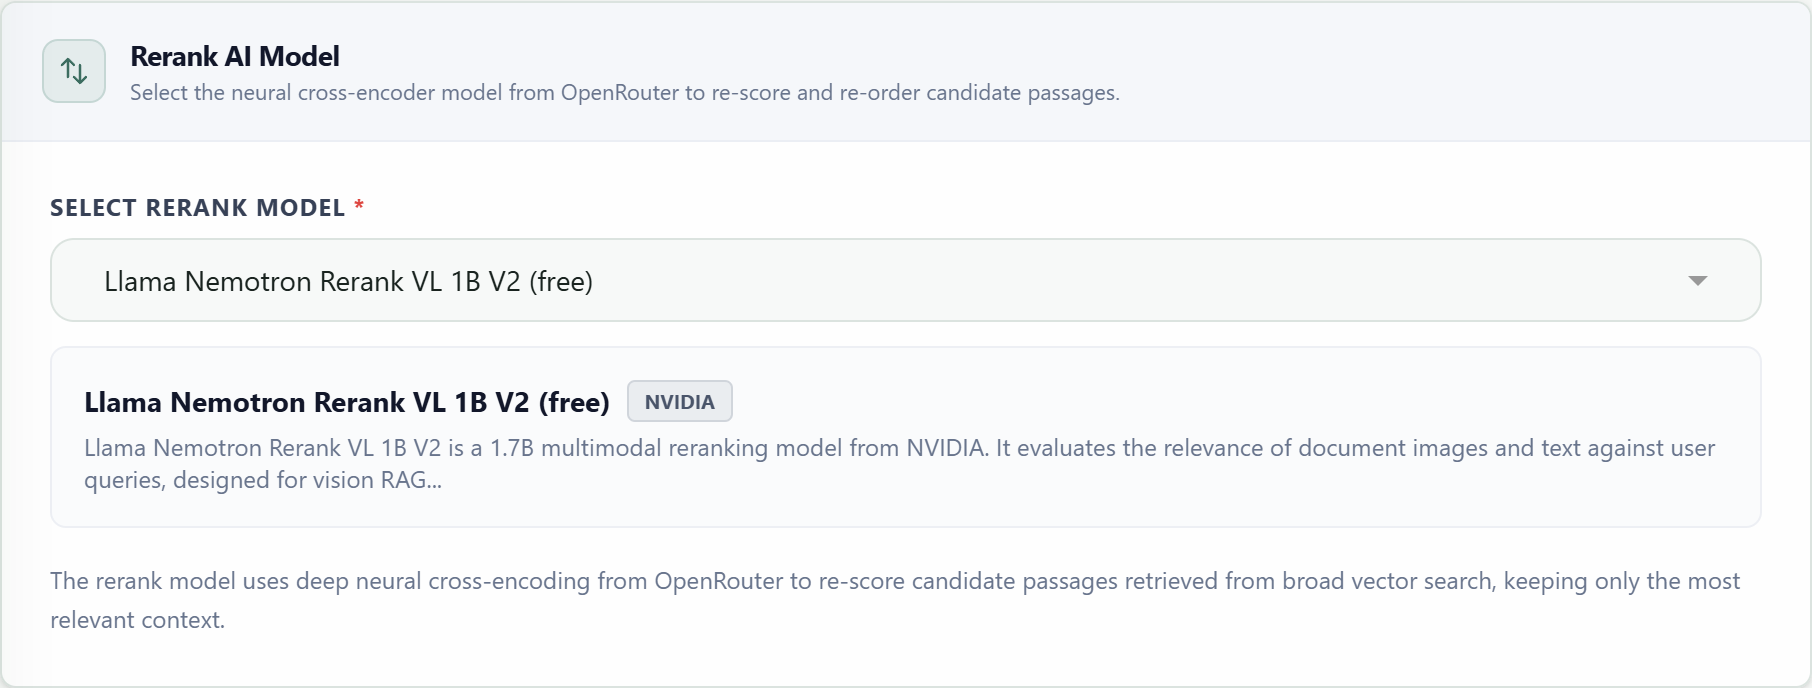
Model de rerankingObligatoriuSelectează cross-encoderul folosit pentru a evalua candidații regăsiți vectorial în raport cu fiecare interogare.
Step 02 · Sections 04–07
Modele AI specializate
Modelele suplimentare apar doar când arhitectura sau o capabilitate opțională are nevoie de ele. Fiecare model de raționament compatibil poate afișa și un selector de efort după selectare.
Model de grafCondiționatExtrage noduri de entități, relații semantice și triple structurate în timpul indexării.
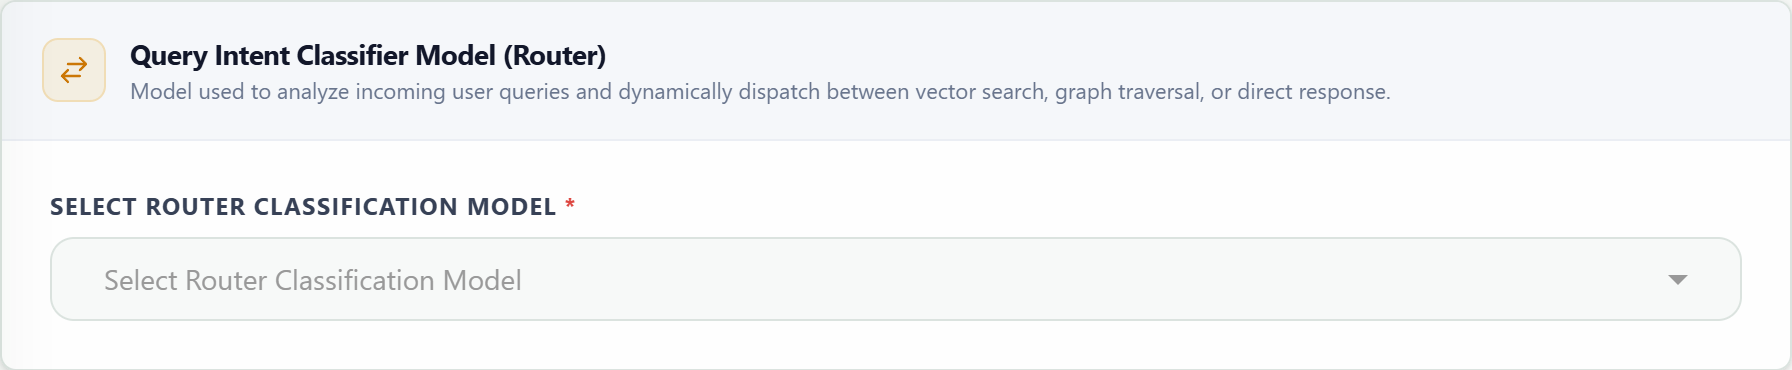
Model routerCondiționatClasifică intenția primită și selectează regăsirea vectorială, parcurgerea grafului sau răspunsul direct.
Model vizualCondiționatDescrie imagini, grafice și diagrame, astfel încât informația vizuală să poată intra în contextul căutabil.
Model de răspunsCondiționatTransformă pasajele regăsite într-un răspuns conversațional ancorat pentru interogări RAG independente și widgeturi.
Efort de raționamentCondiționatAplică un nivel de efort acceptat modelelor de graf, router, vizual sau de răspuns.
TemperaturăCondiționatControlează variația rezultatului generat pentru etapele generative compatibile.
Step 02 · Section 08
Arhitectură și parametri de regăsire
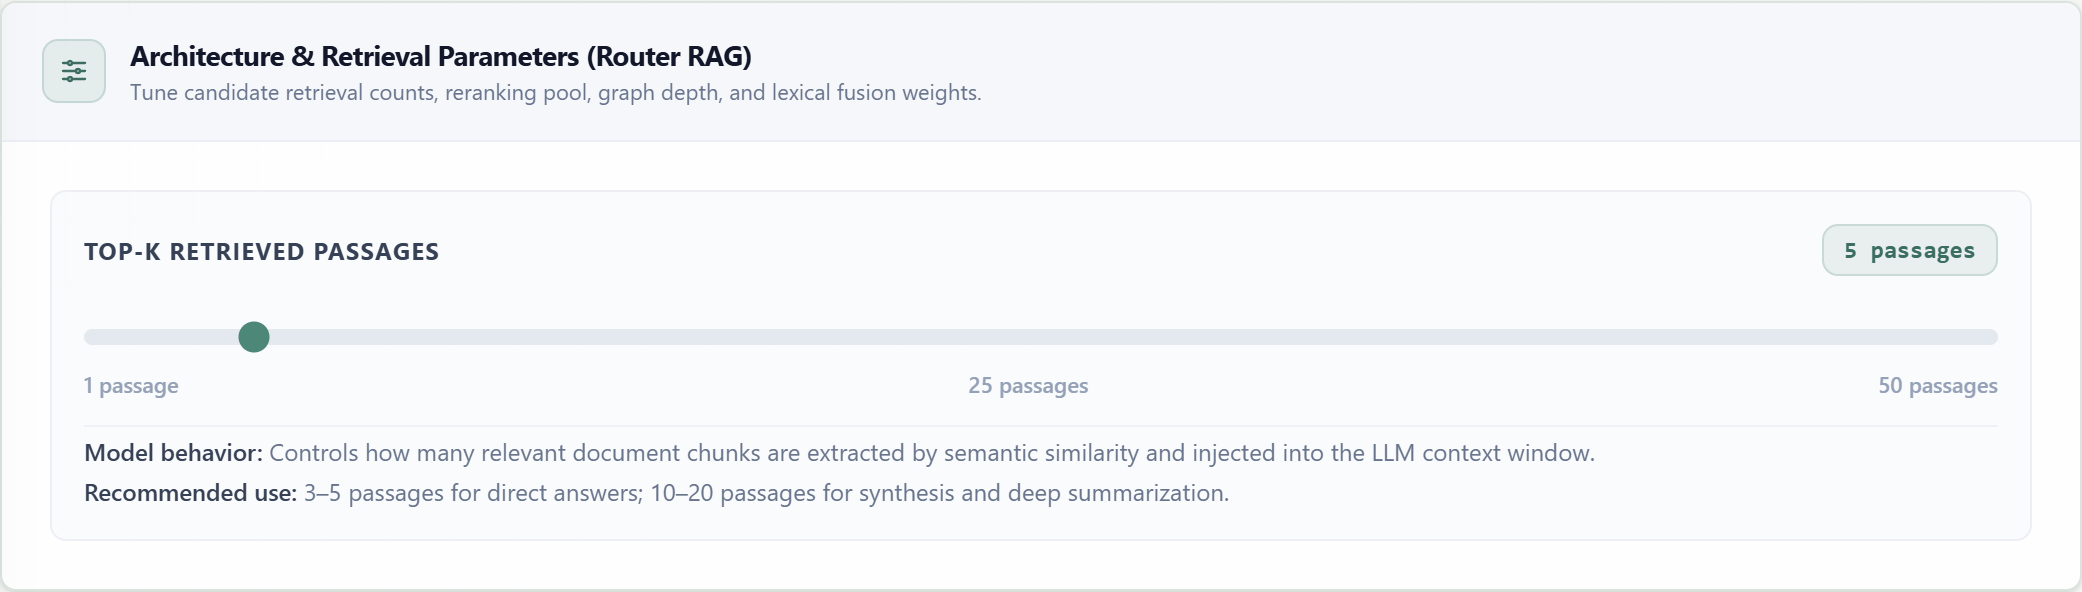
Glisoarele controlează cantitatea de context candidat colectată la fiecare etapă. Cardul se schimbă odată cu tiparul selectat, astfel încât sunt afișați doar parametrii utilizați de acea conductă.
| Parametru | Tipar | Implicit / Interval | Scop |
|---|---|---|---|
| top_k | Naiv, Multimodal, Router | 5 · 1–50 | Pasajele injectate în contextul final. |
| initial_top_k | Retrieve-and-Rerank | 25 · 5–100 | Grupul semantic larg de candidați înainte de reranking. |
| final_top_k | Rerank, Hibrid | 5 · 1–20 | Pasajele păstrate după reranking sau fuziunea clasamentelor. |
| vector_top_k | Graf | 4 · 1–20 | Fragmentele semantice inițiale folosite pentru localizarea entităților grafului. |
| graph_depth | Graf | 1 · 1–3 | Salturile de relații parcurse pornind de la entitățile inițiale. |
| graph_limit | Graf | 20 · 1–100 | Numărul maxim de triple entitate-relație adăugate în context. |
| vector_k | Hibrid | 15 · 1–50 | Candidații semantici denși incluși în fuziunea clasamentelor. |
| bm25_k | Hibrid | 15 · 1–50 | Candidații lexicali rari incluși în fuziunea clasamentelor. |
Step 02 · Section 08
Documentele bazei de cunoștințe
Salvează mai întâi RAG-ul pentru a activa încărcarea documentelor. Fișierele încărcate sunt indexate cu modelul de embedding selectat și devin disponibile pentru regăsire după finalizarea procesării.
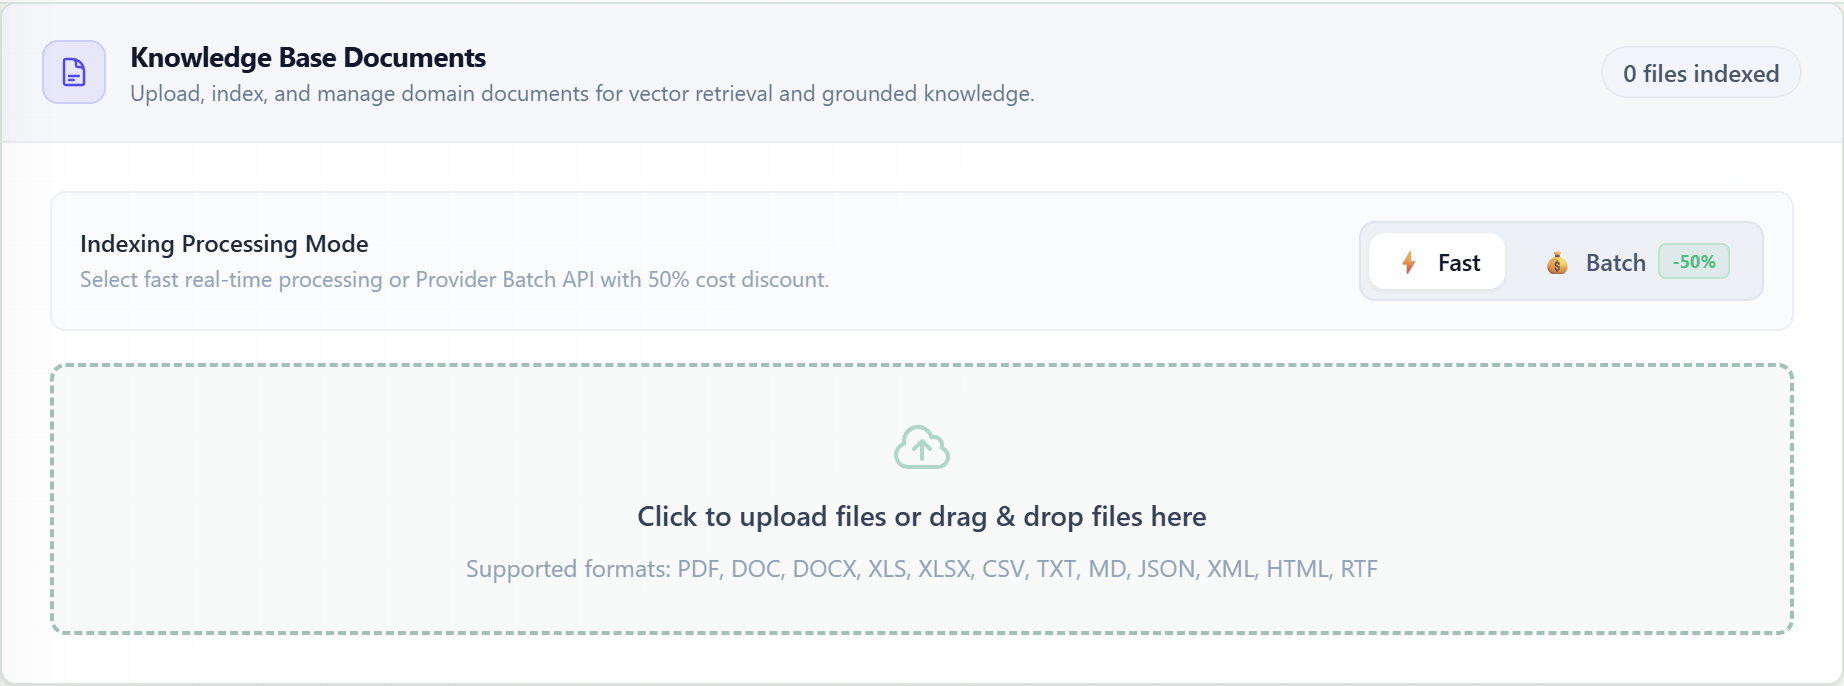
Schimbarea modelului de embedding sau a dimensiunii vectorului după indexare poate necesita reprocesarea documentelor, astfel încât vectorii stocați să rămână compatibili.
Step 02 · Section 09
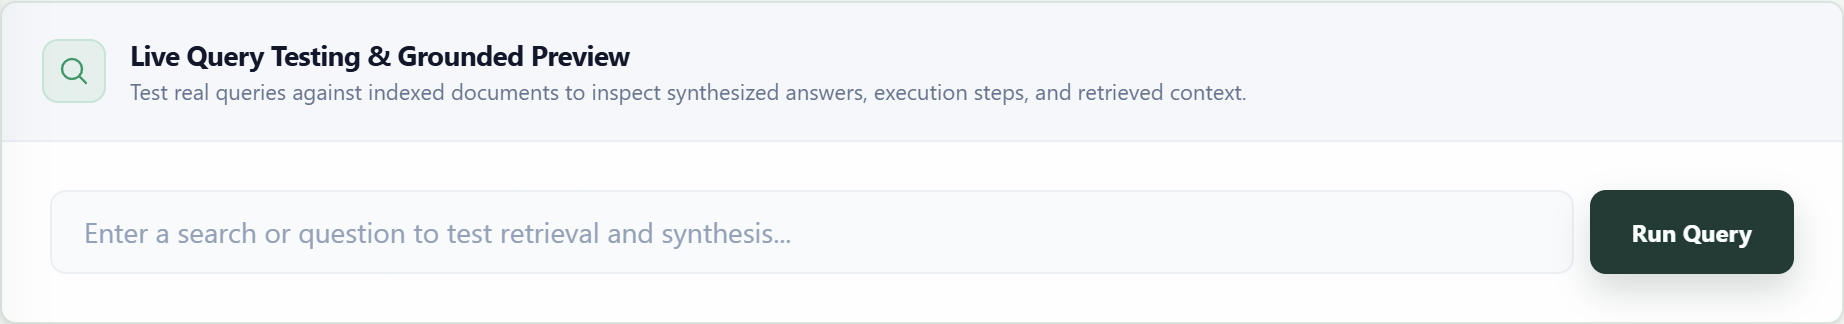
Testarea live a interogărilor
După salvarea și indexarea documentelor, trimite interogări reprezentative pentru a inspecta răspunsul ancorat, fragmentele regăsite, faptele extrase, pașii execuției și contextul asamblat.
Obligatoriu înainte de salvare
Tiparul, numele RAG-ului, modelul de embedding, dimensiunea vectorului și fiecare model cerut de arhitectura selectată.
După creare
Folosește întrebări care necesită fapte exacte și sinteză din mai multe surse, apoi ajustează limitele regăsirii pe baza dovezilor returnate.