
Begründen Sie jede Antwort Ihr Wissen.
Wählen Sie eine Abrufarchitektur aus, konfigurieren Sie deren Modelle und Suchgrenzen und indizieren Sie dann die Dokumente, die Antworten begründen sollen.
Jeder RAG erfordert einen Namen, ein Einbettungsmodell und eine Vektordimension. Diagramm-, Router-, Vision- und Synthesemodelle werden nur angezeigt, wenn ihre Funktionen aktiviert sind.
Überblick
Erstellen Sie eine Abrufpipeline
Eine RAG-Konfiguration konvertiert Quelldokumente in Vektoren und ruft den relevanten Kontext für jede Abfrage ab. Fortgeschrittenere Muster umfassen Reranking, visuelle Extraktion, Graph-Traversal, lexikalische Suche oder absichtsbasiertes Routing.
Wählen Sie die Abrufstrategie entsprechend der Form Ihres Wissens.
Wählen Sie Modelle, Vektordimensionen und begrenzte Abrufparameter aus.
Laden Sie Dokumente hoch, warten Sie auf die Indizierung und überprüfen Sie den Abruf mit echten Abfragen.
Step 01
Wählen Sie ein RAG-Muster aus
Jedes Muster aktiviert einen anderen Abrufpfad und stellt in Schritt zwei nur die relevanten Modell- und Optimierungssteuerelemente bereit.
Direkte semantische Einbettungssuche, gefolgt von fundierter Antwortgenerierung.
Ruft einen breiten Kandidatenpool ab und wendet dann eine neuronale Neubewertung an, um die stärksten Passagen beizubehalten.
Kombiniert die Textsuche mit Beschreibungen, die aus Bildern, Diagrammen und Schaubildern extrahiert wurden.
Extrahiert Entitäten und Beziehungen und durchläuft dann einen Wissensgraphen für Multi-Hop-Kontext.
Vereint dichte Vektorähnlichkeit mit spärlicher BM25-Schlüsselwortübereinstimmung für eine ausgewogene Erinnerung.
Klassifiziert jede Abfrage und leitet sie zwischen Vektorsuche, Diagrammdurchquerung oder direkter Antwort weiter.
Step 02 · Section 01
RAG Details
Identifizieren Sie die Wissensdatenbank und beschreiben Sie den Bereich, der von den indizierten Quellen abgedeckt wird.
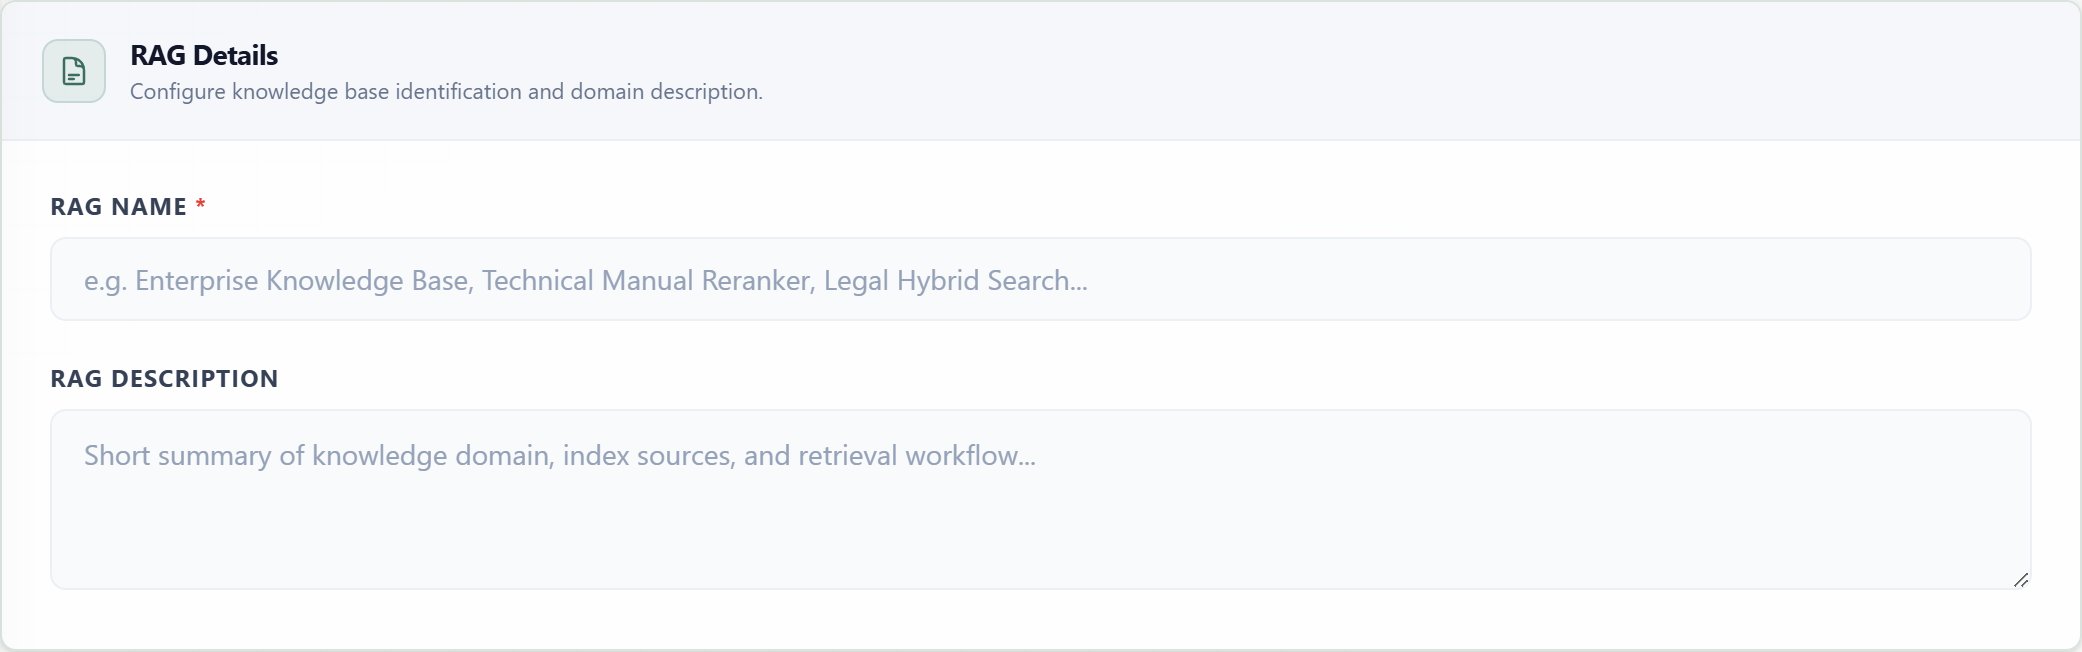
RAG NameDOCS.ERFORDERLICHDer Anzeigename, der in RAG-Verzeichnissen und Selektoren für Agenten, Widgets und API-Ziele verwendet wird.
BeschreibungOptionalEine prägnante Zusammenfassung des Wissensbereichs, des Quellenmaterials und des Abrufzwecks.
Step 02 · Section 02
Vektor-Einbettungsmodell
Das Einbettungsmodell wandelt Dokumentblöcke und Abfragen in numerische Vektoren um. Die ausgewählte Dimension legt die Vektorform fest, die für die Indizierung und Ähnlichkeitssuche verwendet wird.
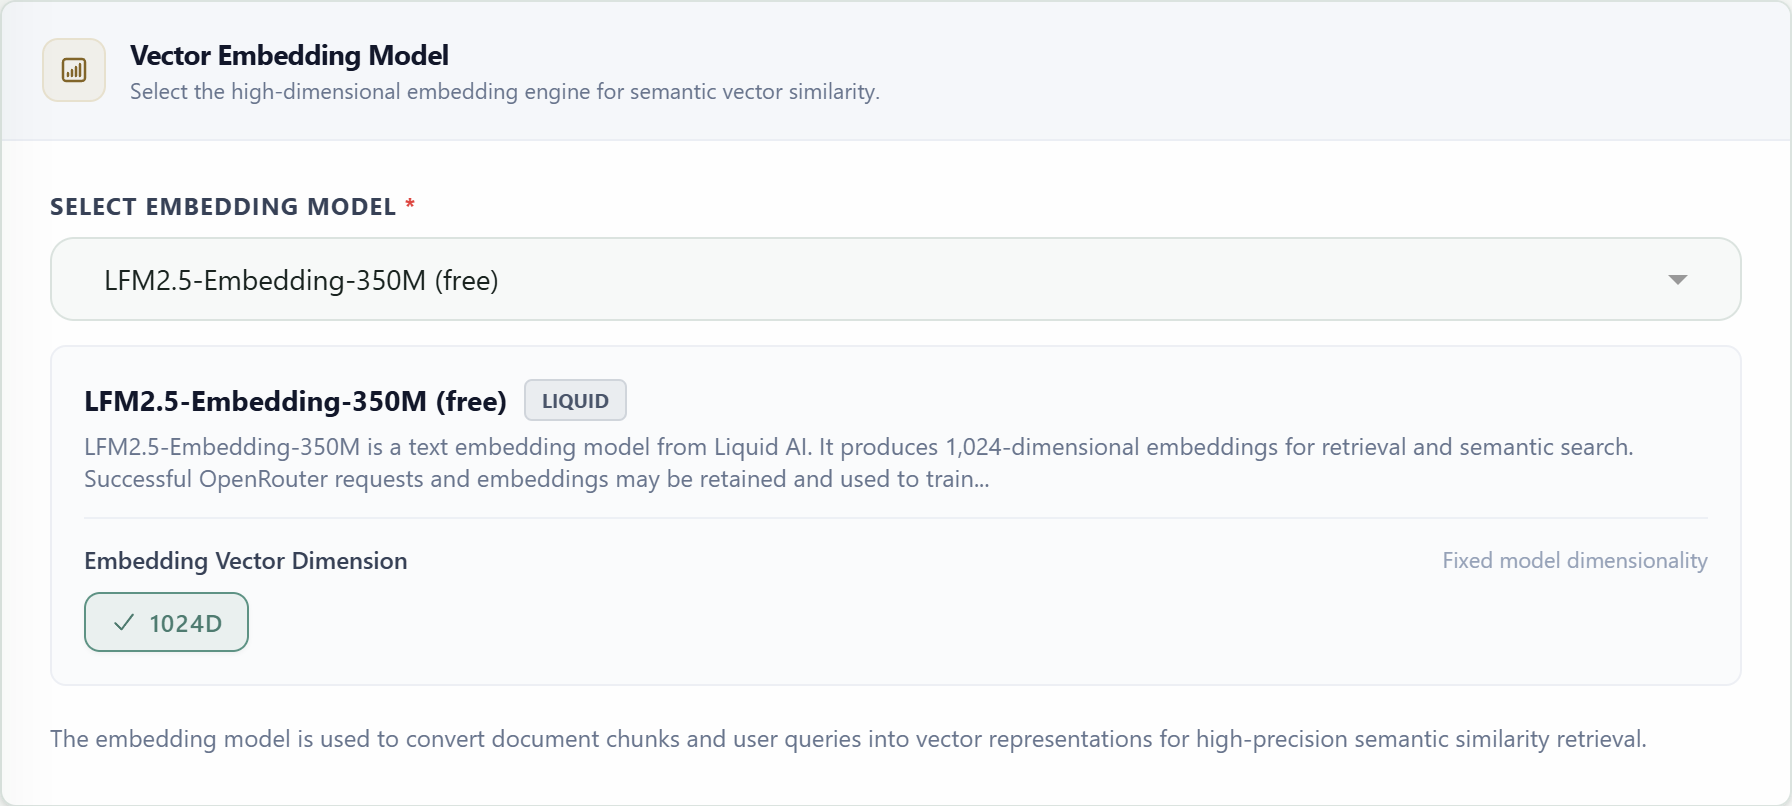
EinbettungsmodellErforderlichWählt das Anbietermodell aus, das zum Codieren sowohl von Dokumentblöcken als auch eingehender Abfragen verwendet wird.
VektordimensionErforderlichLegt die Anzahl der für jede Vektordarstellung gespeicherten numerischen Werte fest.
Step 02 · Section 03
KI-Reranking-Modell
Das Reranking-Modell bewertet jeden Kandidatenabschnitt nach der breiten Vektorsuche mithilfe eines neuronalen Cross-Encoders anhand der Benutzeranfrage. Es ordnet die Kandidaten neu, damit der endgültige Kontext die relevantesten Abschnitte enthält.
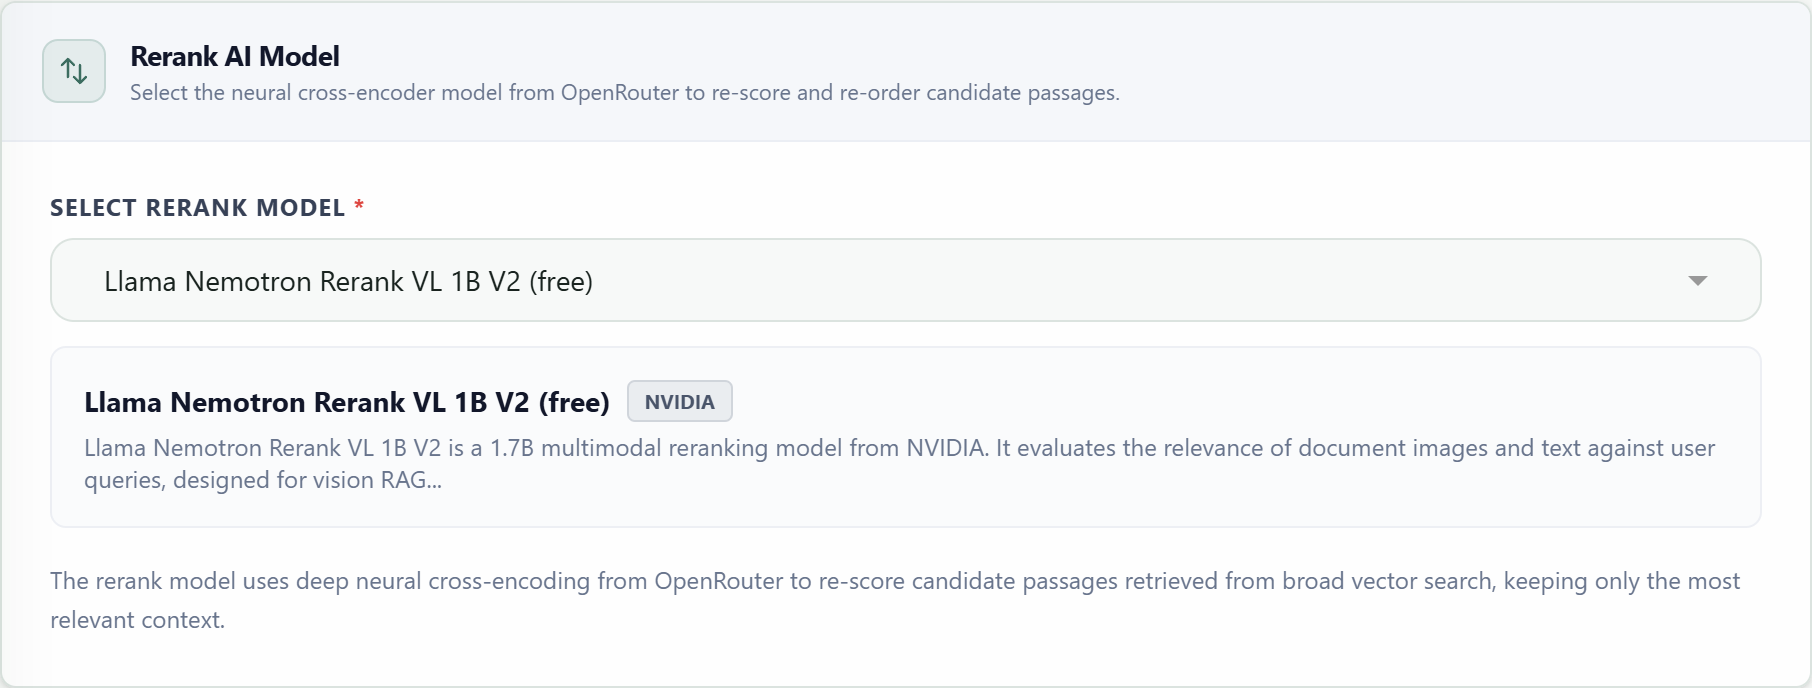
Reranking-ModellErforderlichWählt den Cross-Encoder aus, der die Kandidaten der Vektorsuche anhand jeder Anfrage bewertet.
Step 02 · Sections 04–07
Spezialisierte AI-Modelle
Zusätzliche Modelle werden nur angezeigt, wenn die Architektur oder eine optionale Funktion sie erfordert. Jedes kompatible Argumentationsmodell kann nach der Auswahl auch einen Aufwandsselektor verfügbar machen.
DiagrammmodellBedingtExtrahiert Entitätsknoten, semantische Beziehungen und strukturierte Tripel während der Indizierung.
Router-ModellBedingtKlassifiziert eingehende Absichten und wählt Vektorabruf, Diagrammdurchquerung oder direkte Antwort aus.
VisionsmodellBedingtBeschreibt Bilder, Diagramme und Diagramme, sodass visuelle Informationen in den durchsuchbaren Kontext eingefügt werden können.
ReaktionsmodellBedingtVerwandelt abgerufene Passagen in eine fundierte Konversationsantwort für eigenständige RAG-Abfragen und Widgets.
ArgumentationsaufwandBedingtWendet eine unterstützte Aufwandsstufe auf Diagramm-, Router-, Vision- oder Antwortmodelle an.
TemperaturBedingtSteuert Variationen in der generierten Ausgabe für anwendbare generative Stufen.
Step 02 · Section 08
Architektur- und Abrufparameter
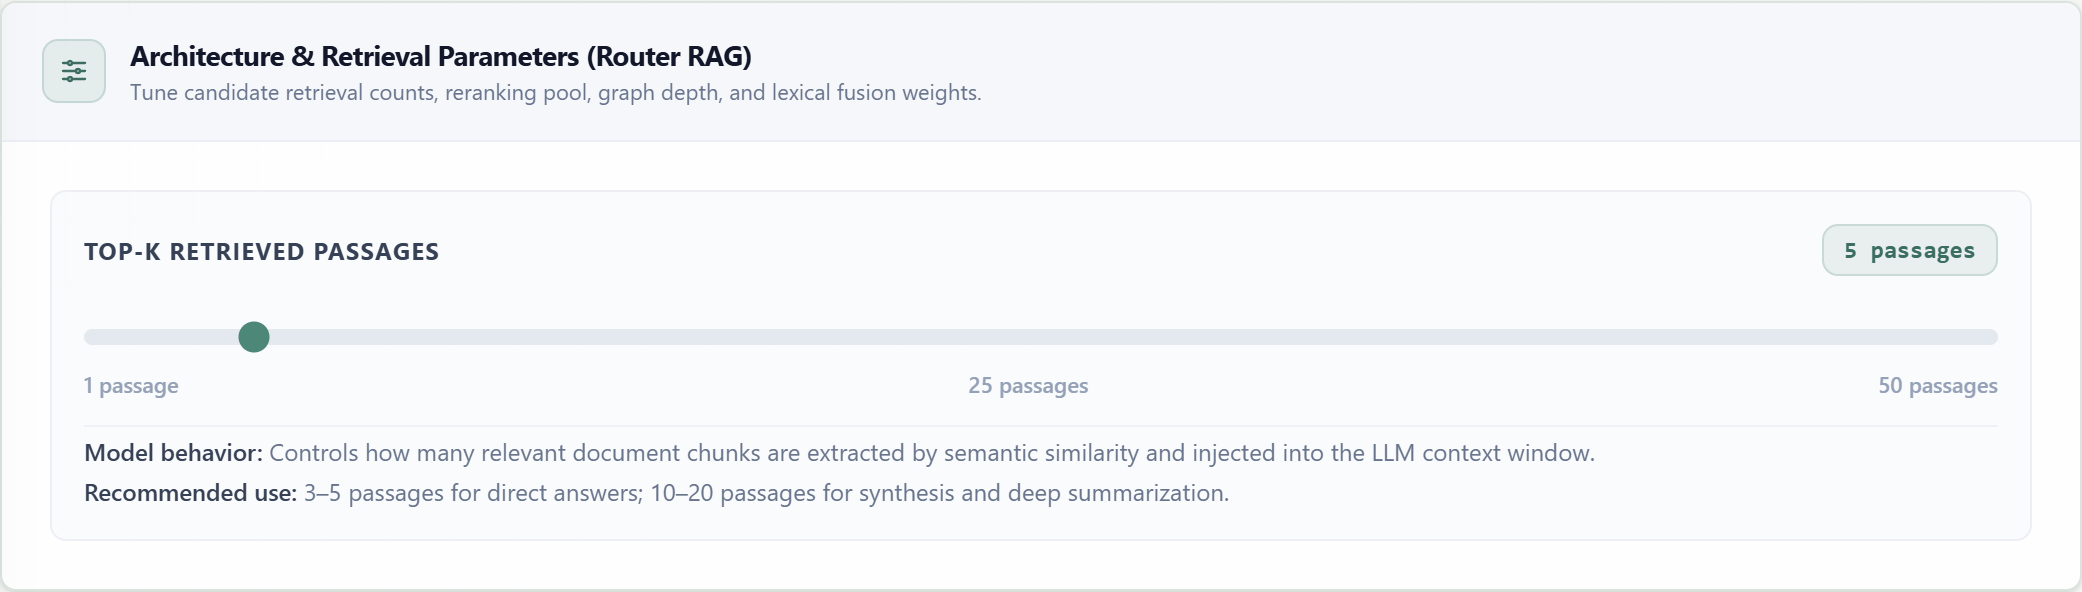
Schieberegler steuern die Menge des Kandidatenkontexts, der in jeder Phase gesammelt wird. Die Karte ändert sich mit dem ausgewählten Muster, sodass nur von dieser Pipeline verwendete Parameter angezeigt werden.
| Parameter | Muster | Standard/Bereich | Zweck |
|---|---|---|---|
| top_k | Naiv, multimodal, Router | 5 · 1–50 | Passagen, die in den endgültigen Kontext eingefügt werden. |
| initial_top_k | Abrufen und neu einordnen | 25 · 5–100 | Breiter semantischer Kandidatenpool vor dem Reranking. |
| final_top_k | Neu einordnen, Hybrid | 5 · 1–20 | Passagen bleiben nach Rangänderung oder Rangverschmelzung erhalten. |
| vector_top_k | Graph | 4 · 1–20 | Semantische Seed-Chunks, die zum Auffinden von Diagrammentitäten verwendet werden. |
| graph_length | Graph | 1 · 1–3 | Von den Seed-Entitäten ausgehende Beziehungssprünge. |
| graph_limit | Graph | 20 · 1–100 | Maximale Entitäts-Beziehungs-Tripel, die dem Kontext hinzugefügt wurden. |
| vector_k | Hybrid | 15 · 1–50 | Dichte semantische Kandidaten, die in die Rangfusion einbezogen werden. |
| bm25_k | Hybrid | 15 · 1–50 | In der Rangverschmelzung enthaltene spärliche lexikalische Kandidaten. |
Step 02 · Section 08
Dokumente der Wissensdatenbank
Speichern Sie zuerst RAG, um das Hochladen von Dokumenten zu ermöglichen. Hochgeladene Dateien werden mit dem ausgewählten Einbettungsmodell indiziert und stehen nach Abschluss der Verarbeitung zum Abruf zur Verfügung.
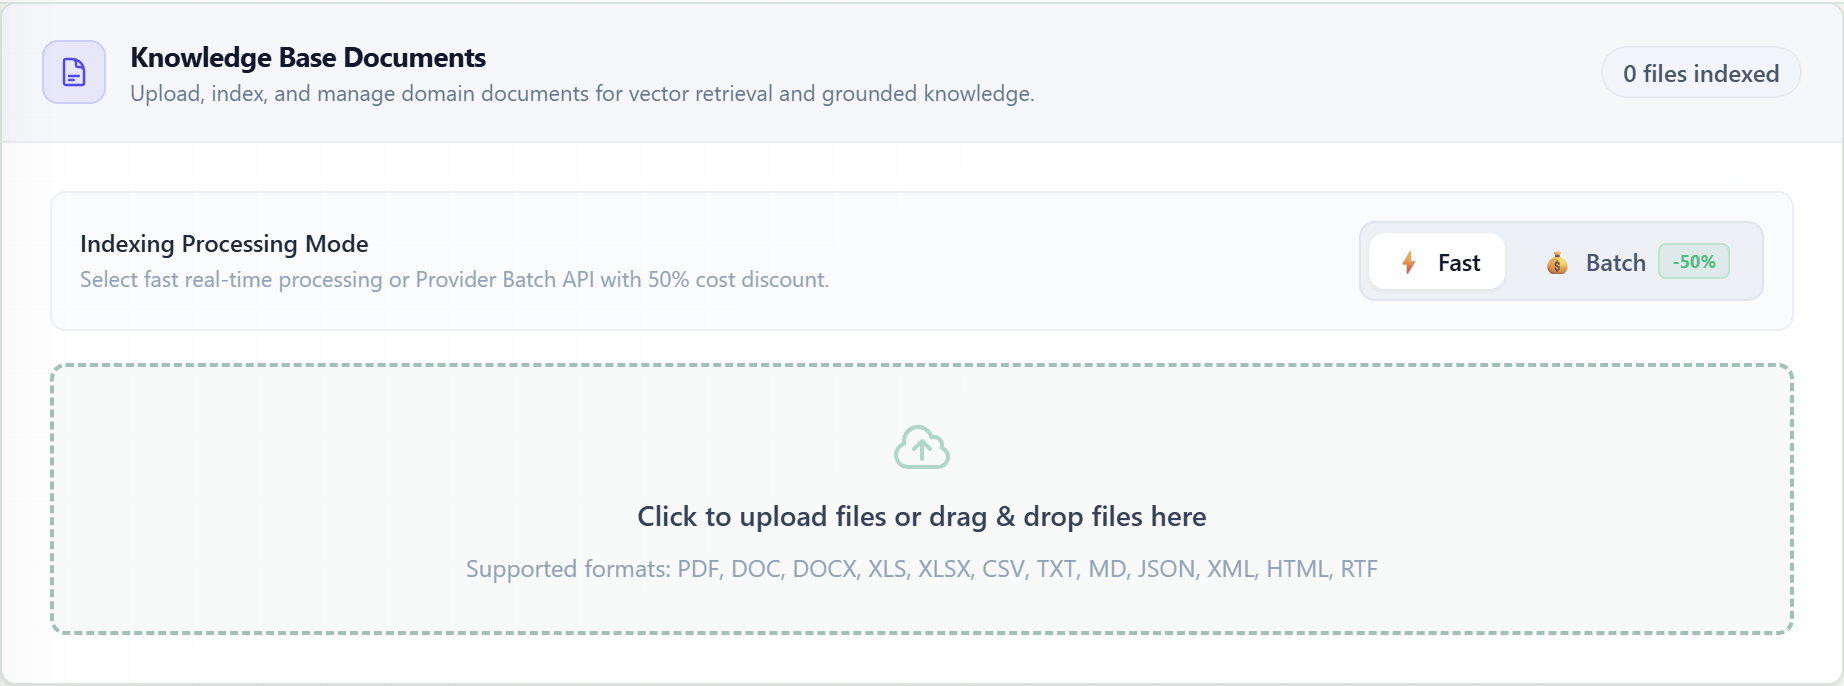
Das Ändern des Einbettungsmodells oder der Vektordimension nach der Indizierung kann eine erneute Verarbeitung von Dokumenten erforderlich machen, damit gespeicherte Vektoren kompatibel bleiben.
Step 02 · Section 09
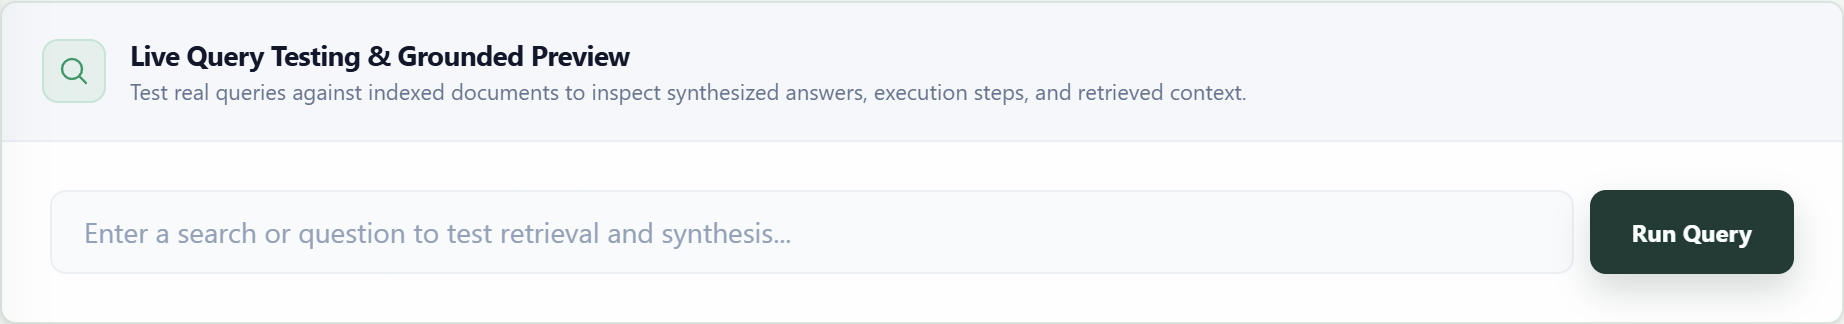
Live-Abfragetests
Senden Sie nach dem Speichern und Indizieren von Dokumenten repräsentative Abfragen, um die fundierte Antwort, die abgerufenen Teile, die extrahierten Fakten, die Ausführungsschritte und den zusammengestellten Kontext zu überprüfen.
Vor dem Speichern erforderlich
Muster, RAG-Name, Einbettungsmodell, Vektordimension und jedes für die ausgewählte Architektur erforderliche Modell.
Nach der Schöpfung
Verwenden Sie Fragen, die genaue Fakten und eine Synthese aus mehreren Quellen erfordern, und passen Sie dann die Abrufgrenzen basierend auf den zurückgegebenen Beweisen an.