
Fondez chaque réponse dans vos connaissances.
Sélectionnez une architecture de récupération, configurez ses modèles et ses limites de recherche, puis indexez les documents qui doivent étayer les réponses.
Chaque RAG nécessite un nom, un modèle d'intégration et une dimension vectorielle. Les modèles graphiques, de routeur, de vision et de synthèse n'apparaissent que lorsque leurs fonctionnalités sont activées.
Aperçu
Créer un pipeline de récupération
Une configuration RAG convertit les documents sources en vecteurs et récupère le contexte pertinent pour chaque requête. Des modèles plus avancés ajoutent le reclassement, l'extraction visuelle, la traversée de graphiques, la recherche lexicale ou le routage basé sur l'intention.
Choisissez la stratégie de récupération adaptée à la forme de vos connaissances.
Sélectionnez des modèles, des dimensions vectorielles et des paramètres de récupération limités.
Téléchargez des documents, attendez l'indexation et inspectez la récupération avec de vraies requêtes.
Step 01
Sélectionnez un modèle RAG
Chaque modèle active un chemin de récupération différent et expose uniquement son modèle et ses commandes de réglage pertinents à la deuxième étape.
Recherche d'intégration sémantique directe suivie d'une génération de réponses fondées.
Récupère un large pool de candidats, puis applique un reclassement neuronal pour conserver les passages les plus forts.
Combine la récupération de texte avec des descriptions extraites d'images, de graphiques et de diagrammes.
Extrait les entités et les relations, puis parcourt un graphe de connaissances pour un contexte multi-sauts.
Fusionne une similarité vectorielle dense avec une correspondance de mots clés BM25 clairsemée pour un rappel équilibré.
Classifie chaque requête et l'achemine entre une recherche vectorielle, un parcours graphique ou une réponse directe.
Step 02 · Section 01
RAG Détails
Identifiez la base de connaissances et décrivez le domaine couvert par ses sources indexées.
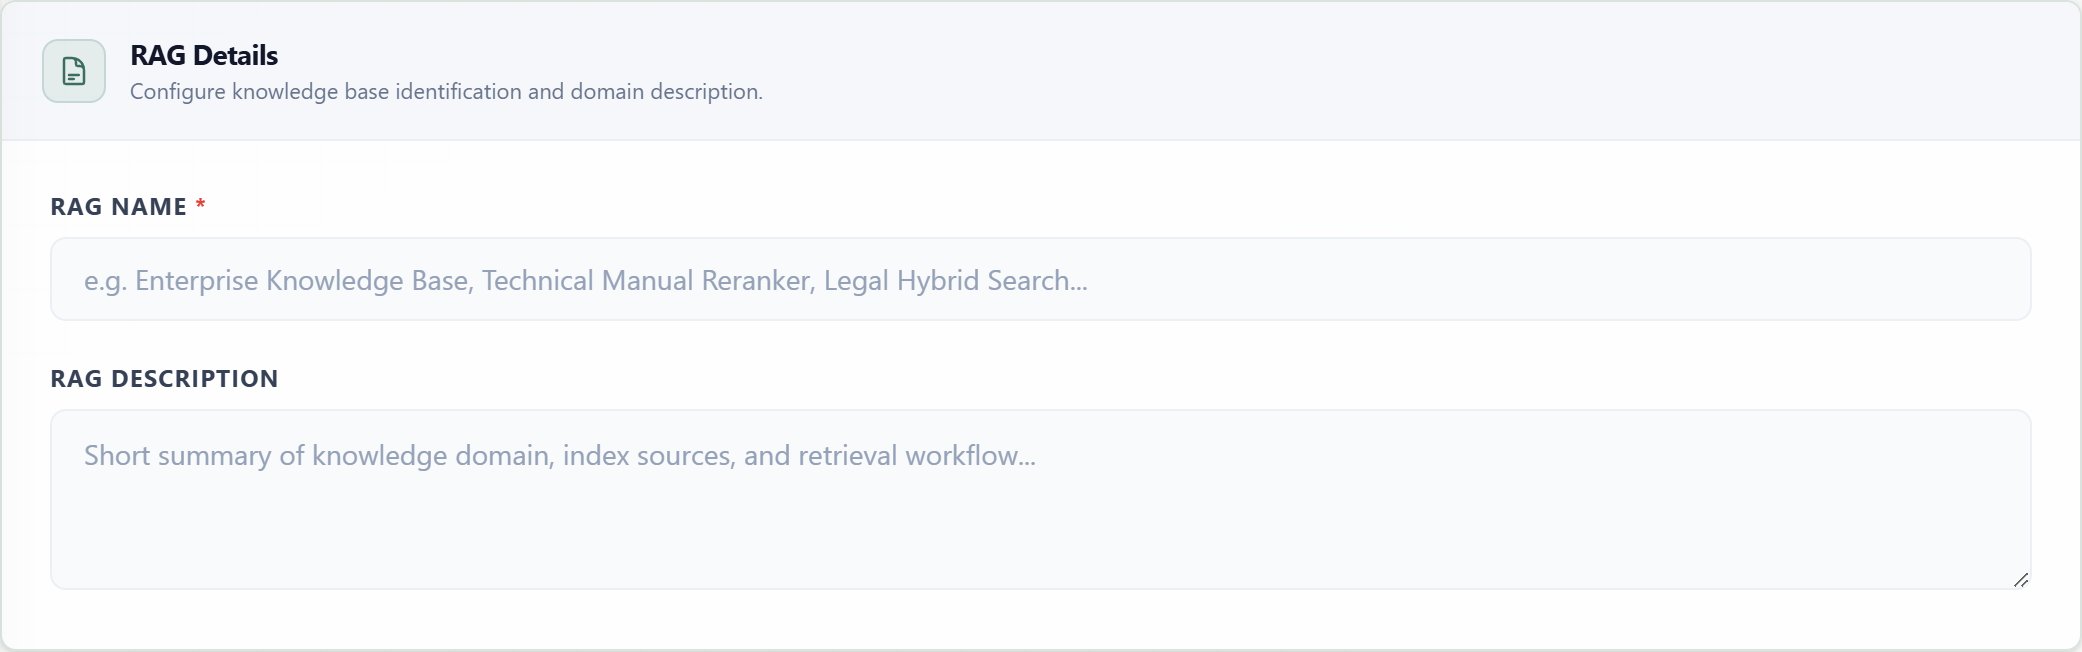
Nom RAGDOCS.REQUISNom d'affichage utilisé dans les répertoires et sélecteurs RAG pour les agents, les widgets et les cibles API.
DescriptionDOCS.FACULTATIVEUn résumé concis du domaine de connaissances, du matériel source et du but de la récupération.
Step 02 · Section 02
Modèle d'intégration de vecteurs
Le modèle d'intégration convertit les fragments de documents et les requêtes en vecteurs numériques. La dimension sélectionnée fixe la forme vectorielle utilisée pour l'indexation et la recherche de similarité.
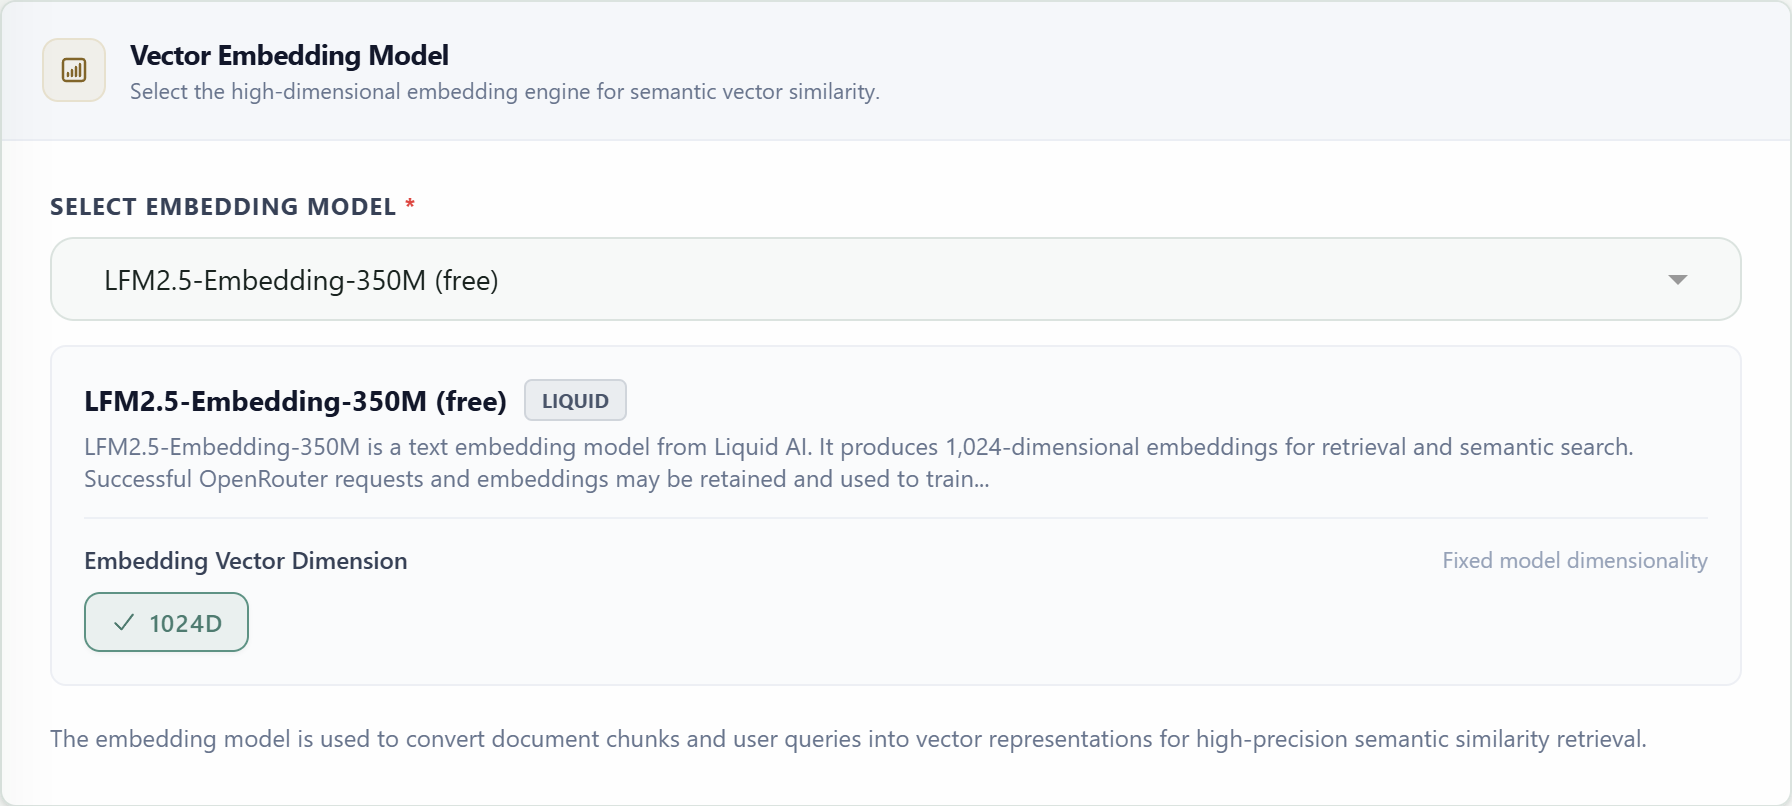
Modèle d'intégrationRequisSélectionne le modèle de fournisseur utilisé pour encoder à la fois les morceaux de document et les requêtes entrantes.
Dimension vectorielleRequisDéfinit le nombre de valeurs numériques stockées pour chaque représentation vectorielle.
Step 02 · Section 03
Modèle IA de reclassement
Le modèle de reclassement applique un cross-encoder neuronal pour évaluer chaque passage candidat au regard de la requête après une large recherche vectorielle. Il réordonne les candidats afin que le contexte final conserve les passages les plus pertinents.
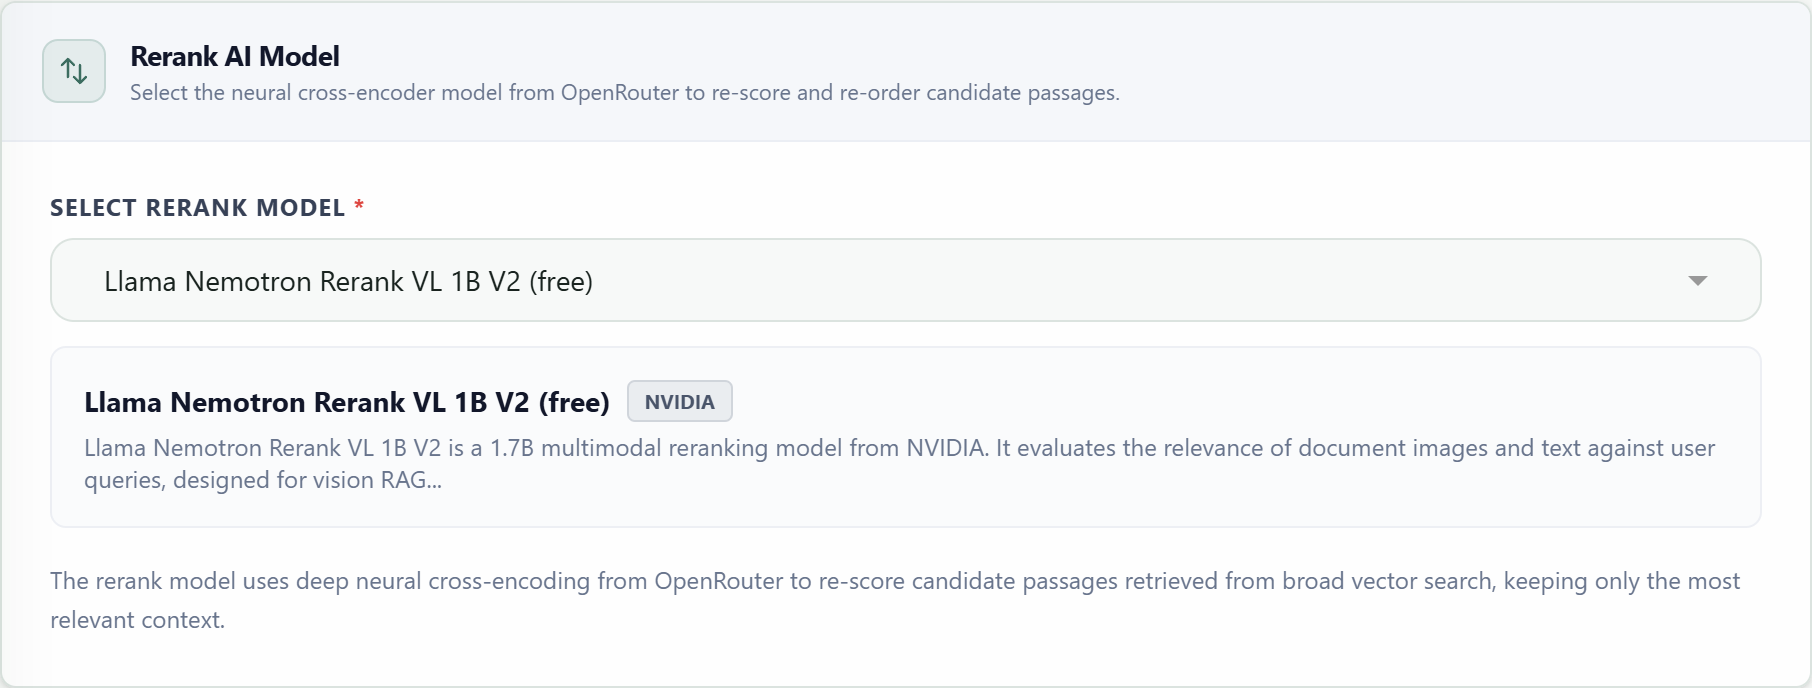
Modèle de reclassementRequisSélectionne le cross-encoder utilisé pour évaluer les candidats issus de la recherche vectorielle par rapport à chaque requête.
Step 02 · Sections 04–07
Modèles AI spécialisés
Des modèles supplémentaires apparaissent uniquement lorsque l'architecture ou une fonctionnalité facultative en a besoin. Chaque modèle de raisonnement compatible peut également exposer un sélecteur d'effort après sélection.
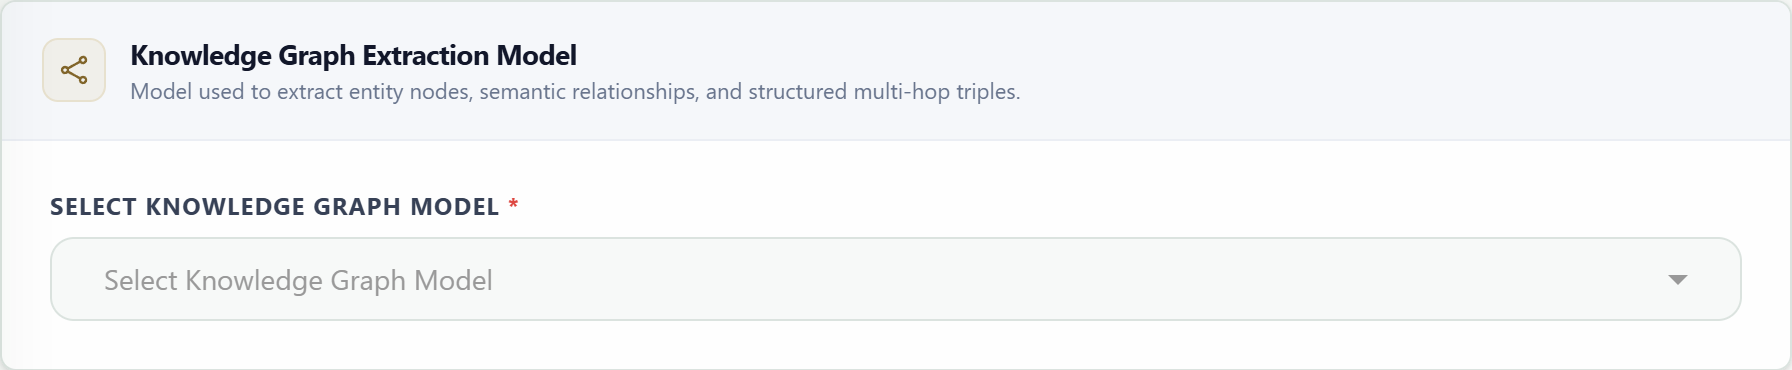
Modèle graphiqueConditionnelleExtrait les nœuds d'entité, les relations sémantiques et les triples structurés lors de l'indexation.
Modèle de routeurConditionnelleClassifie l'intention entrante et sélectionne la récupération de vecteurs, le parcours graphique ou la réponse directe.
Modèle de visionConditionnelleDécrit des images, des graphiques et des diagrammes afin que les informations visuelles puissent rejoindre le contexte de recherche.
Modèle de réponseConditionnelleTransforme les passages récupérés en une réponse conversationnelle fondée pour les requêtes et widgets RAG autonomes.
Effort de raisonnementConditionnelleApplique un niveau d'effort pris en charge aux modèles de graphique, de routeur, de vision ou de réponse.
TempératureConditionnelleContrôle la variation de la sortie générée pour les étapes génératives applicables.
Step 02 · Section 08
Paramètres d'architecture et de récupération
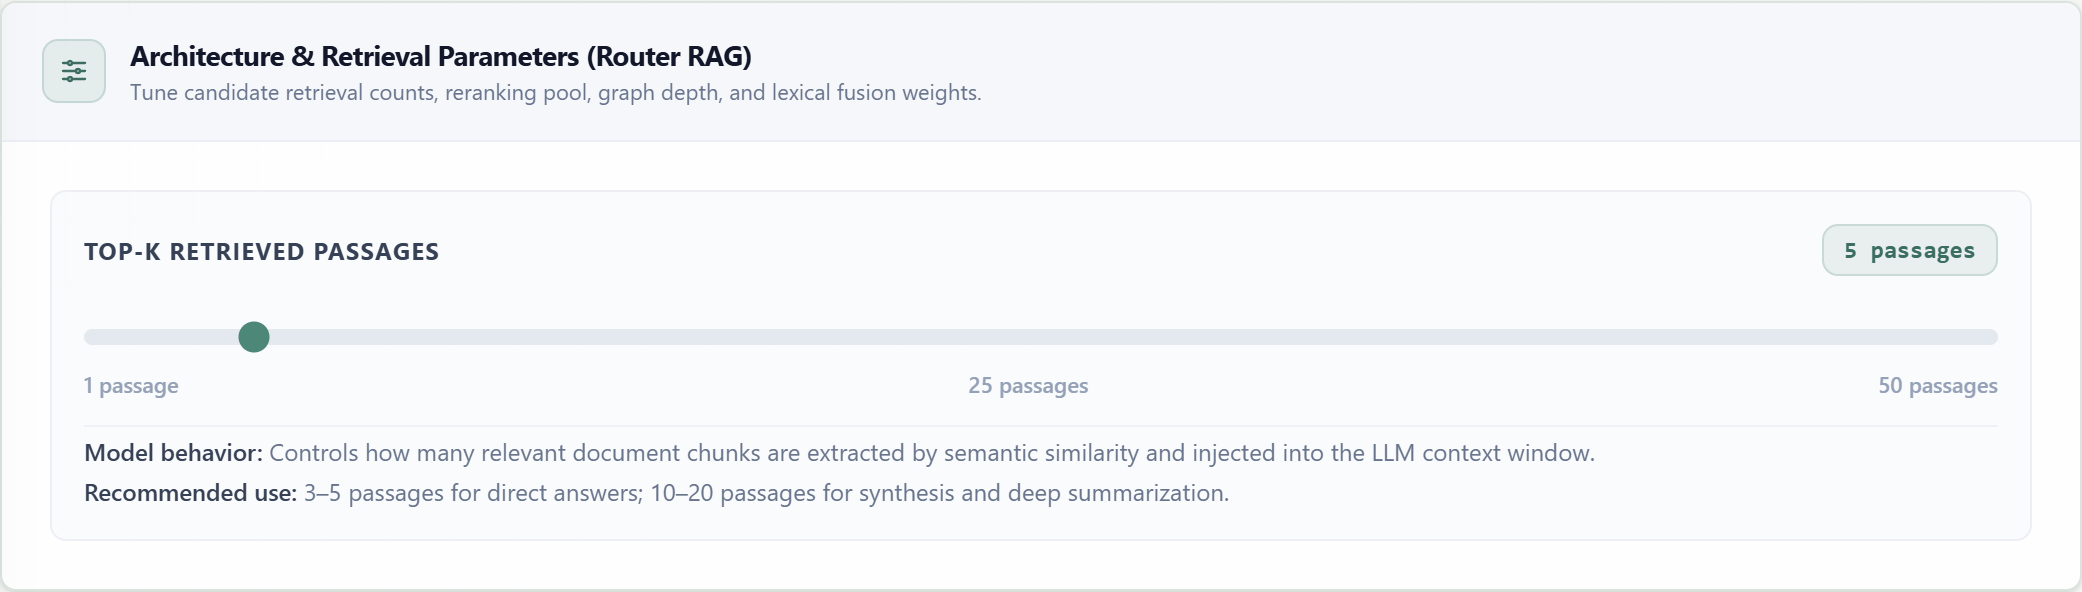
Les curseurs contrôlent la quantité de contexte candidat collecté à chaque étape. La carte change avec le modèle sélectionné, de sorte que seuls les paramètres utilisés par ce pipeline sont affichés.
| Paramètre | Modèle | Par défaut/plage | But |
|---|---|---|---|
| top_k | Naïf, multimodal, routeur | 5 · 1-50 | Passages injectés dans le contexte final. |
| initial_top_k | Récupérer et reclasser | 25 · 5-100 | Large pool de candidats sémantiques avant reclassement. |
| final_top_k | Reclassement, hybride | 5 · 1-20 | Passages conservés après reclassement ou fusion de rang. |
| vecteur_top_k | Graphique | 4 · 1-20 | Morceaux de départ sémantiques utilisés pour localiser les entités graphiques. |
| graph_profondeur | Graphique | 1 · 1–3 | Sauts de relation traversés à partir des entités de départ. |
| graph_limite | Graphique | 20 · 1-100 | Triples entité-relation maximum ajoutés au contexte. |
| vecteur_k | Hybride | 15 · 1-50 | Candidats sémantiques denses inclus dans la fusion de rangs. |
| bm25_k | Hybride | 15 · 1-50 | Candidats lexicaux clairsemés inclus dans la fusion de rangs. |
Step 02 · Section 08
Documents de la base de connaissances
Enregistrez d'abord le RAG pour activer le téléchargement de documents. Les fichiers téléchargés sont indexés avec le modèle d'intégration sélectionné et deviennent disponibles pour la récupération une fois le traitement terminé.
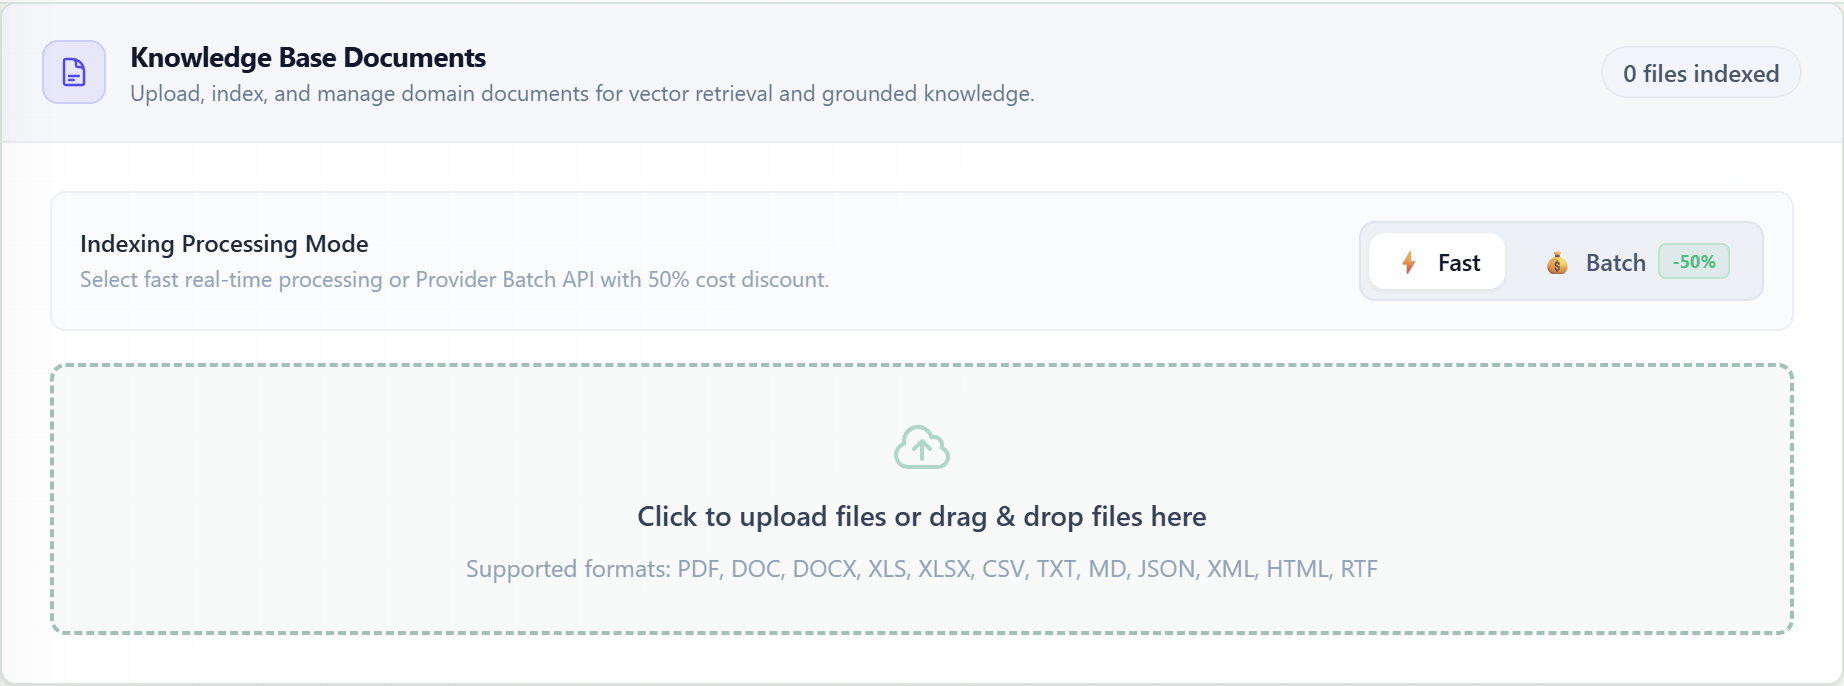
La modification du modèle d'intégration ou de la dimension vectorielle après l'indexation peut nécessiter le retraitement des documents afin que les vecteurs stockés restent compatibles.
Step 02 · Section 09
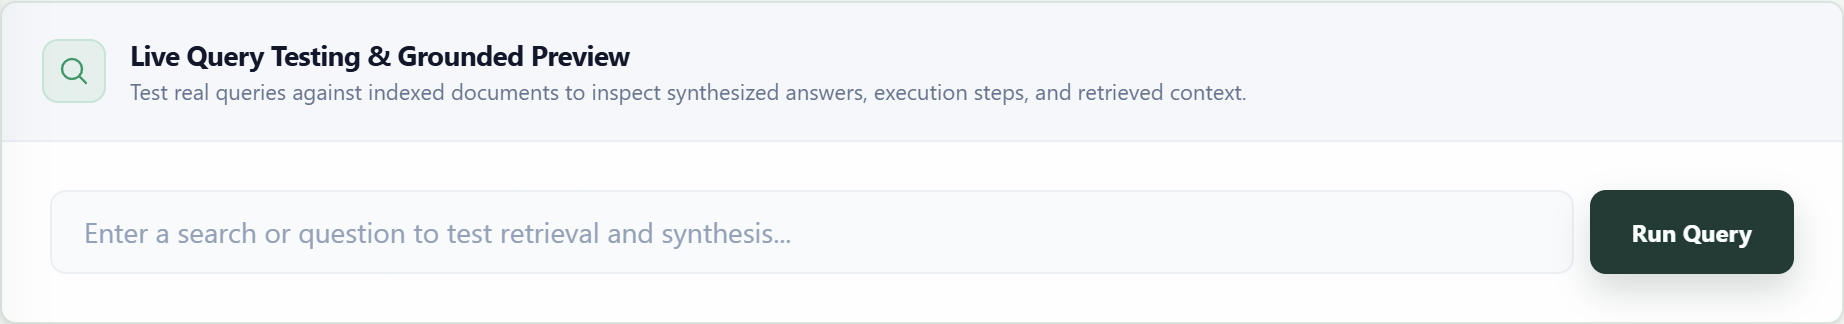
Test de requêtes en direct
Après avoir enregistré et indexé les documents, soumettez des requêtes représentatives pour inspecter la réponse fondée, les morceaux récupérés, les faits extraits, les étapes d'exécution et le contexte assemblé.
Obligatoire avant l'enregistrement
Modèle, nom RAG, modèle d'intégration, dimension vectorielle et chaque modèle requis par l'architecture sélectionnée.
Après la création
Utilisez des questions qui nécessitent des faits exacts et une synthèse multi-sources, puis ajustez les limites de récupération en fonction des preuves renvoyées.