
Fundamente cada resposta em seu conhecimento.
Selecione uma arquitetura de recuperação, configure seus modelos e limites de pesquisa e, em seguida, indexe os documentos que devem fundamentar as respostas.
Cada RAG requer um nome, modelo de incorporação e dimensão vetorial. Os modelos de gráfico, roteador, visão e síntese aparecem somente quando seus recursos estão habilitados.
Visão geral
Crie um pipeline de recuperação
Uma configuração RAG converte documentos de origem em vetores e recupera o contexto relevante para cada consulta. Padrões mais avançados incluem reclassificação, extração visual, travessia de gráfico, pesquisa lexical ou roteamento baseado em intenção.
Escolha a estratégia de recuperação de acordo com o formato do seu conhecimento.
Selecione modelos, dimensões vetoriais e parâmetros de recuperação limitados.
Faça upload de documentos, aguarde a indexação e inspecione a recuperação com consultas reais.
Step 01
Selecione um padrão RAG
Cada padrão ativa um caminho de recuperação diferente e expõe apenas seu modelo relevante e controles de ajuste na etapa dois.
Pesquisa direta de incorporação semântica seguida de geração de resposta fundamentada.
Recupera um amplo conjunto de candidatos e, em seguida, aplica a reclassificação neural para manter as passagens mais fortes.
Combina recuperação de texto com descrições extraídas de imagens, gráficos e diagramas.
Extrai entidades e relacionamentos e, em seguida, percorre um gráfico de conhecimento para contexto de vários saltos.
Combina similaridade vetorial densa com correspondência esparsa de palavras-chave BM25 para recuperação balanceada.
Classifica cada consulta e a encaminha entre pesquisa vetorial, travessia de gráfico ou resposta direta.
Step 02 · Section 01
Detalhes RAG
Identifique a base de conhecimento e descreva o domínio coberto por suas fontes indexadas.
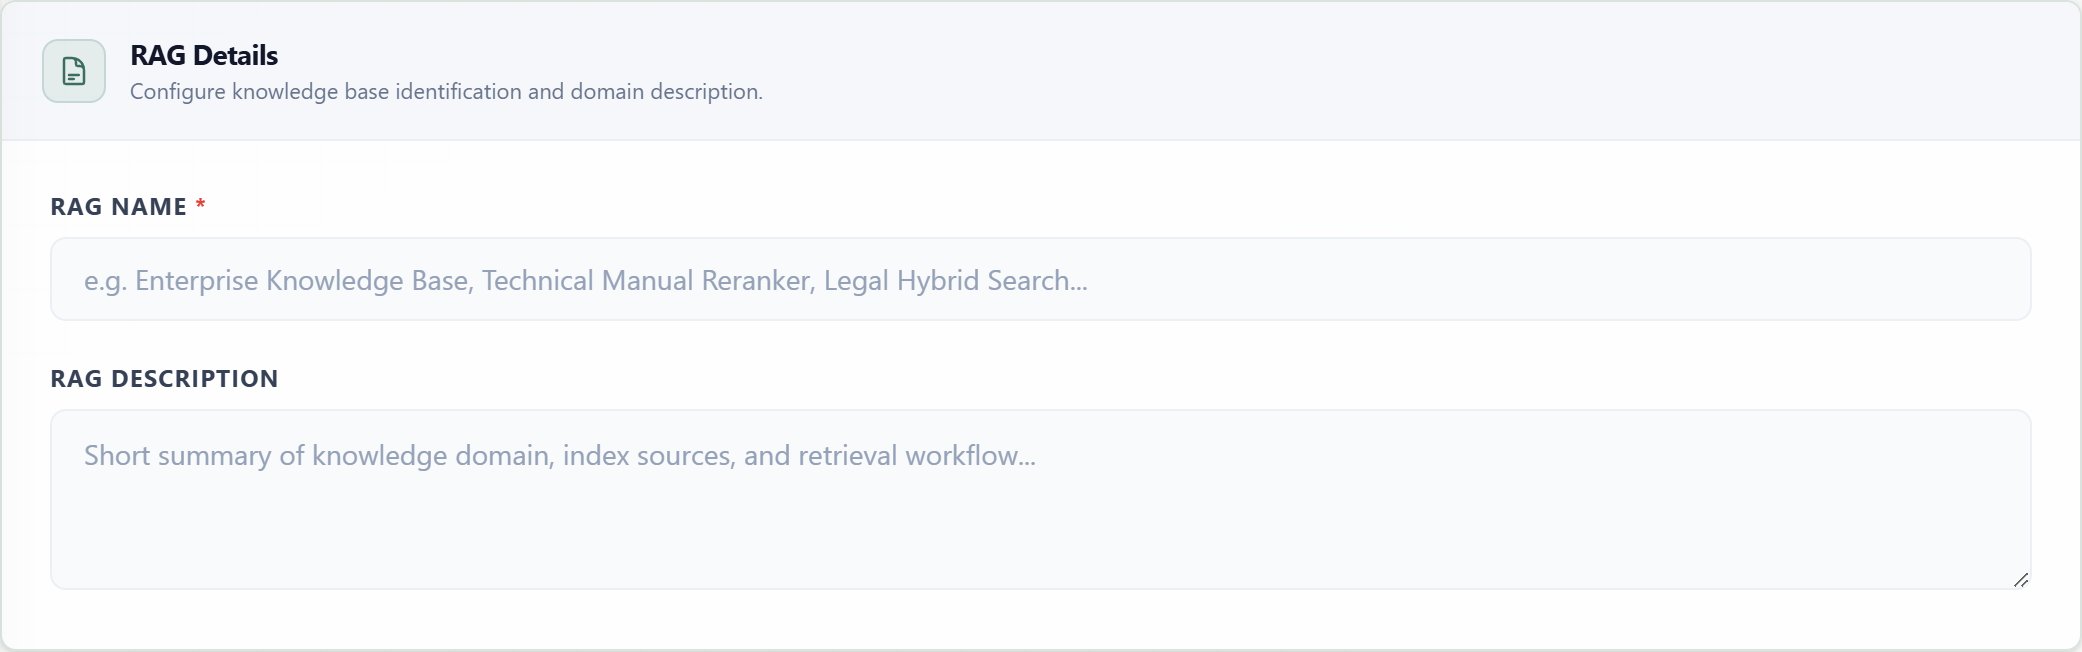
Nome RAGDOCS.OBRIGATÓRIAO nome de exibição usado em diretórios e seletores RAG para agentes, widgets e destinos API.
DescriçãoDOCS.OPCIONALUm resumo conciso do domínio do conhecimento, material de origem e finalidade de recuperação.
Step 02 · Section 02
Modelo de incorporação vetorial
O modelo de incorporação converte blocos de documentos e consultas em vetores numéricos. A dimensão selecionada fixa a forma do vetor usada para indexação e pesquisa de similaridade.
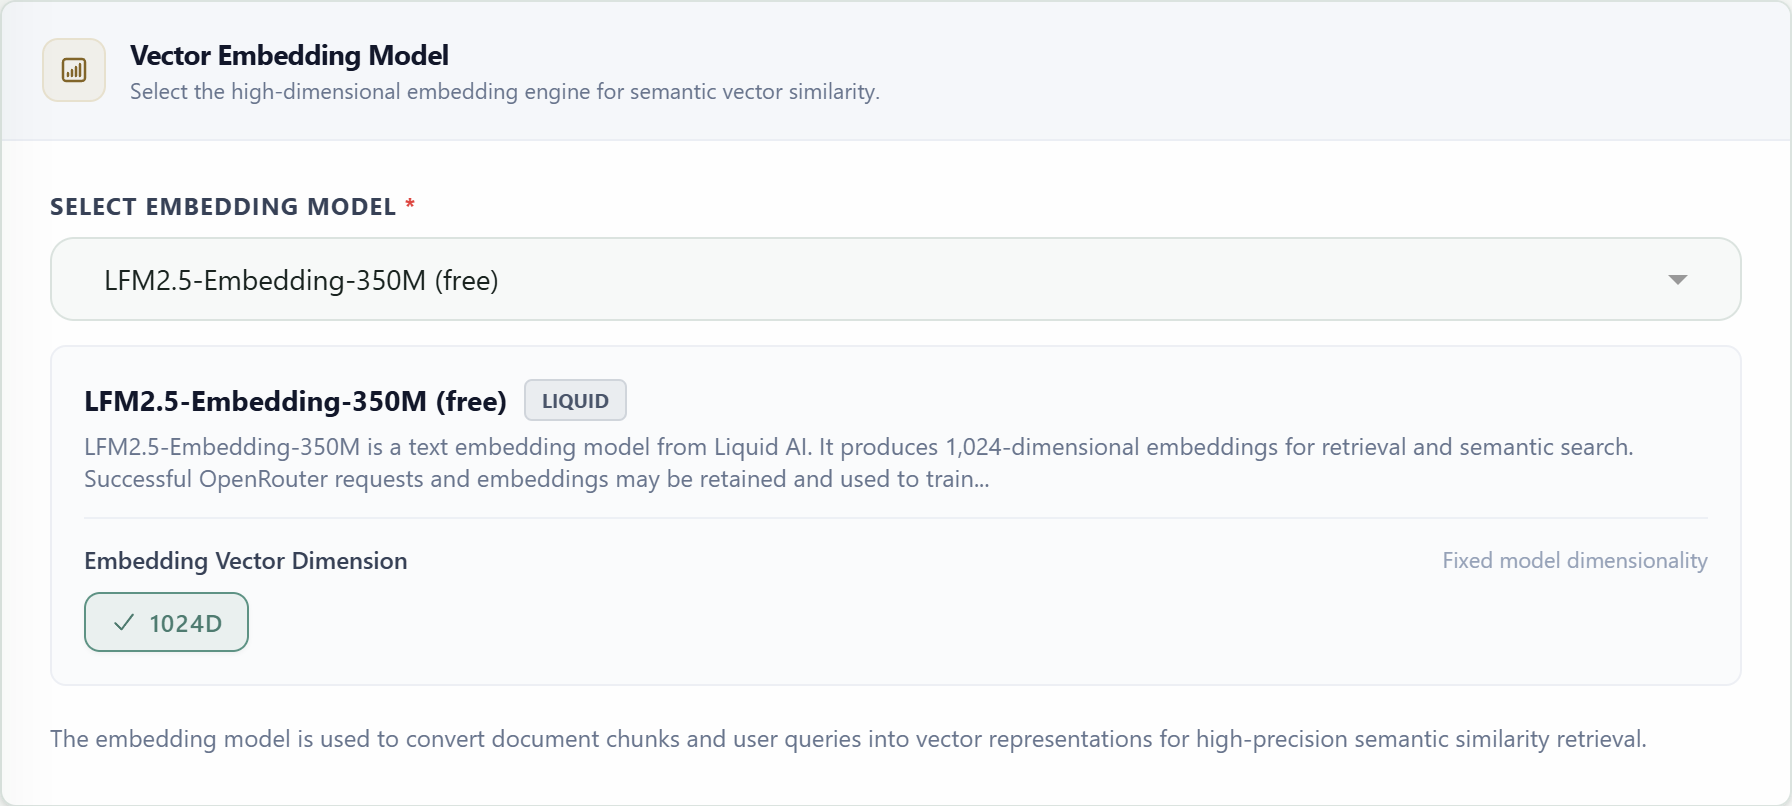
Modelo de incorporaçãoObrigatóriaSeleciona o modelo de provedor usado para codificar blocos de documentos e consultas recebidas.
Dimensão vetorialObrigatóriaDefine o número de valores numéricos armazenados para cada representação vetorial.
Step 02 · Section 03
Modelo de IA de reranking
O modelo de reranking aplica um cross-encoder neural para avaliar cada passagem candidata em relação à consulta do usuário após uma ampla recuperação vetorial. Ele reordena os candidatos para que o contexto final mantenha as passagens mais relevantes.
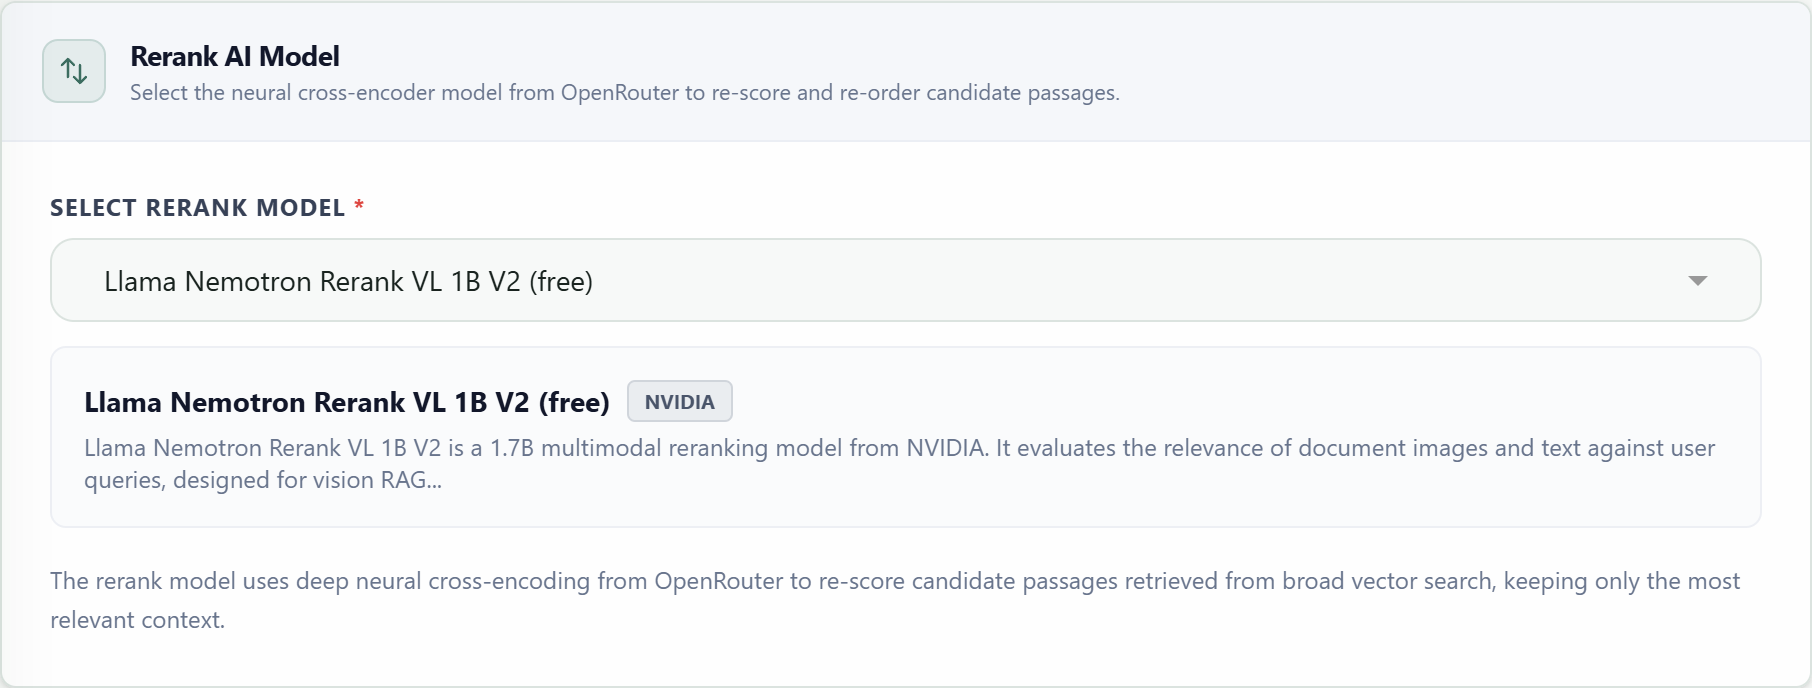
Modelo de rerankingObrigatóriaSeleciona o cross-encoder usado para avaliar os candidatos da pesquisa vetorial em relação a cada consulta.
Step 02 · Sections 04–07
Modelos especializados AI
Modelos adicionais aparecem apenas quando a arquitetura ou um recurso opcional precisa deles. Cada modelo de raciocínio compatível também pode expor um seletor de esforço após a seleção.
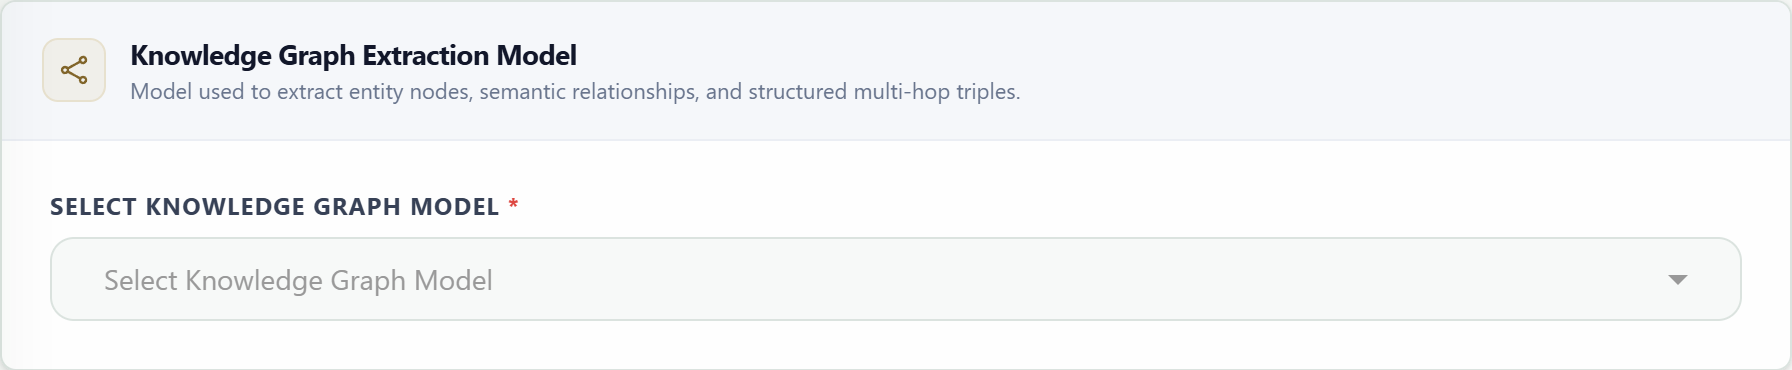
Modelo gráficoCondicionalExtrai nós de entidade, relacionamentos semânticos e triplos estruturados durante a indexação.
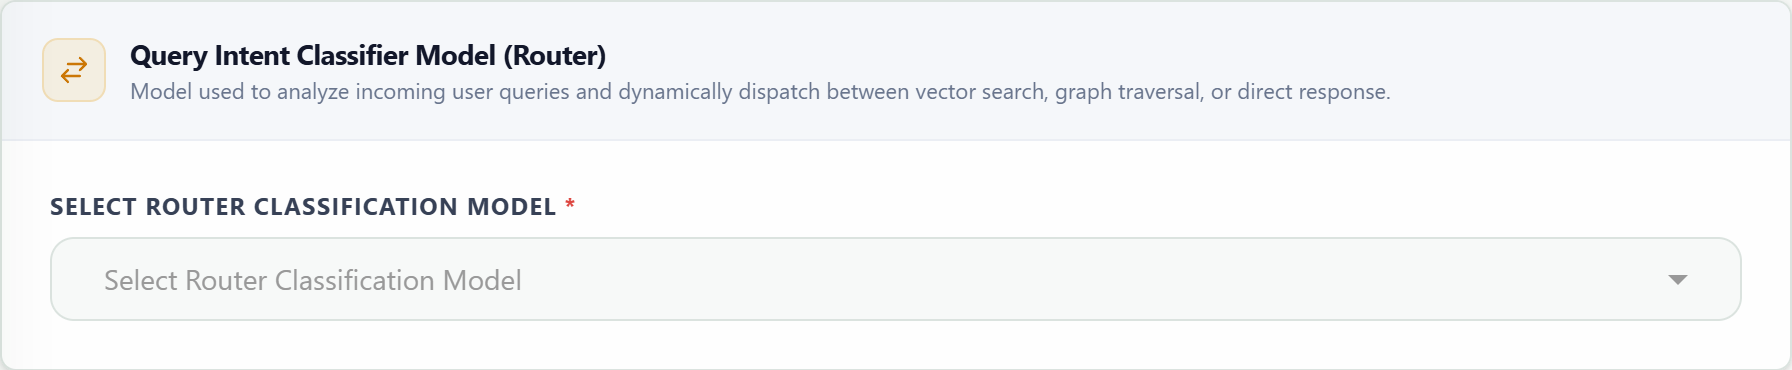
Modelo de roteadorCondicionalClassifica a intenção de entrada e seleciona recuperação de vetor, passagem de gráfico ou resposta direta.
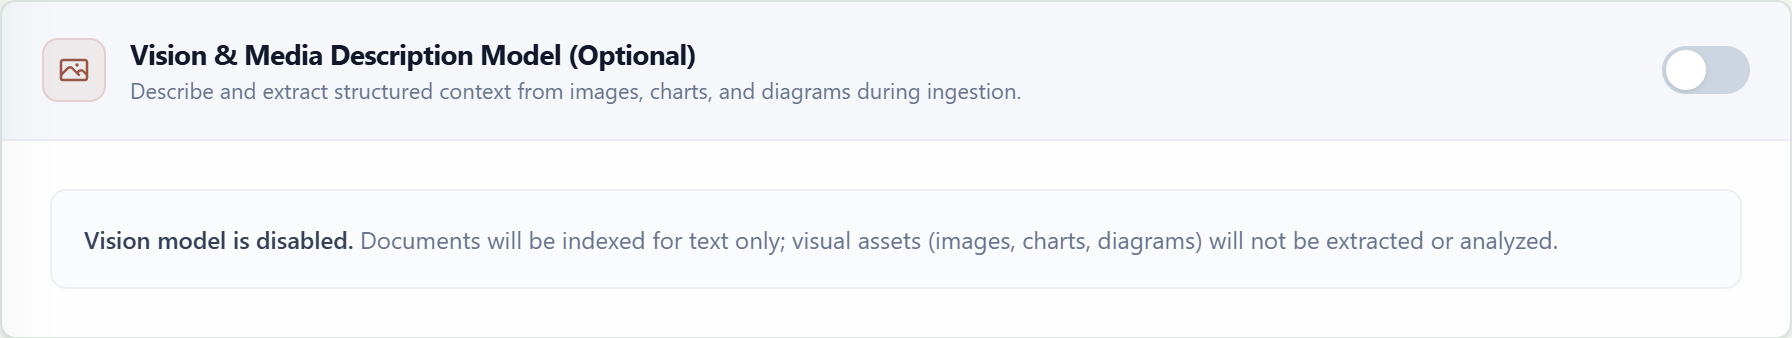
Modelo de VisãoCondicionalDescreve imagens, gráficos e diagramas para que as informações visuais possam se juntar ao contexto pesquisável.
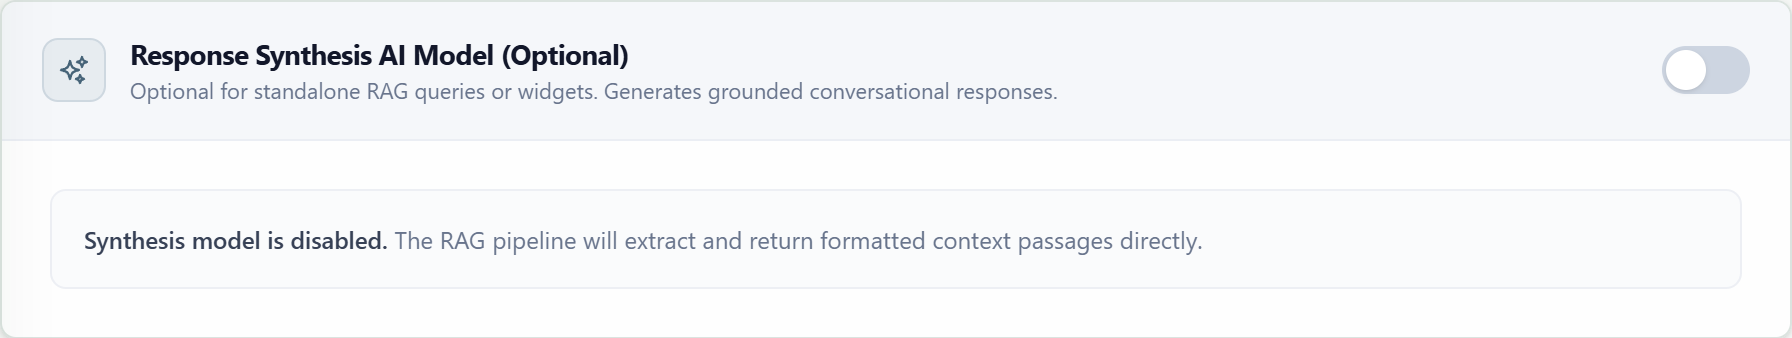
Modelo de RespostaCondicionalTransforma passagens recuperadas em uma resposta de conversação fundamentada para consultas e widgets RAG independentes.
Esforço de raciocínioCondicionalAplica um nível de esforço suportado a modelos de gráfico, roteador, visão ou resposta.
TemperaturaCondicionalControla a variação na saída gerada para estágios geradores aplicáveis.
Step 02 · Section 08
Parâmetros de arquitetura e recuperação
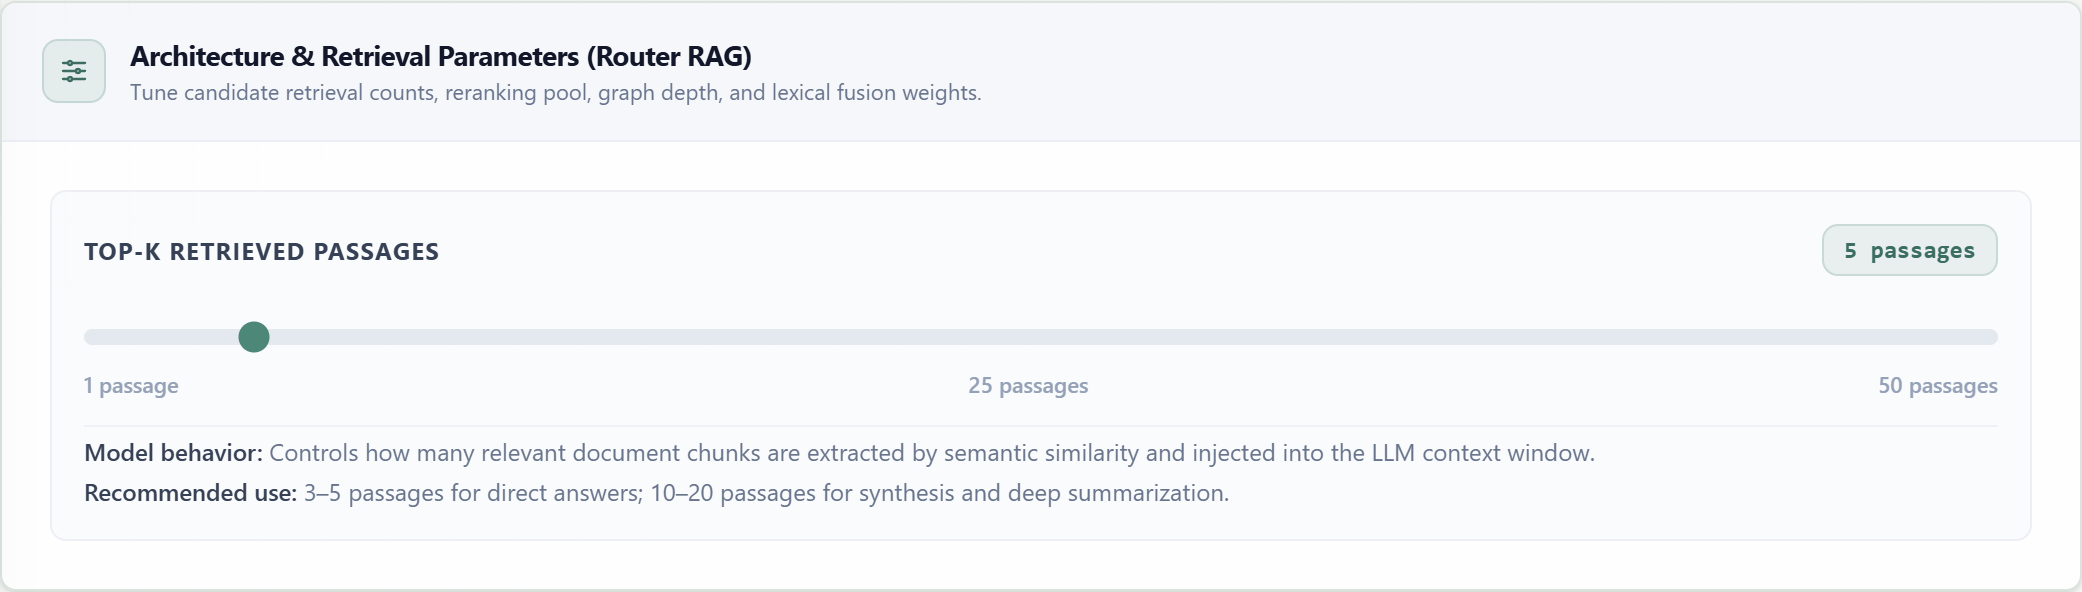
Os controles deslizantes controlam a quantidade de contexto candidato coletado em cada estágio. O cartão muda com o padrão selecionado, portanto, apenas os parâmetros usados por esse pipeline são mostrados.
| Parâmetro | Padrão | Padrão/Intervalo | Propósito |
|---|---|---|---|
| top_k | Ingênuo, Multimodal, Roteador | 5 · 1–50 | Passagens injetadas no contexto final. |
| inicial_top_k | Recuperar e reclassificar | 25 · 5–100 | Amplo conjunto semântico de candidatos antes da reclassificação. |
| final_top_k | Reclassificar, Híbrido | 5 · 1–20 | Passagens retidas após reclassificação ou fusão de classificação. |
| vetor_top_k | Gráfico | 4 · 1–20 | Pedaços iniciais semânticos usados para localizar entidades gráficas. |
| profundidade_grafo | Gráfico | 1 · 1–3 | Saltos de relacionamento percorridos a partir das entidades iniciais. |
| gráfico_limite | Gráfico | 20 · 1–100 | Máximo de triplos entidade-relação adicionados ao contexto. |
| vetor_k | Híbrida | 15 · 1–50 | Candidatos semânticos densos incluídos na fusão de classificações. |
| bm25_k | Híbrida | 15 · 1–50 | Candidatos lexicais esparsos incluídos na fusão de classificações. |
Step 02 · Section 08
Documentos da base de conhecimento
Salve RAG primeiro para permitir uploads de documentos. Os arquivos carregados são indexados com o modelo de incorporação selecionado e ficam disponíveis para recuperação após a conclusão do processamento.
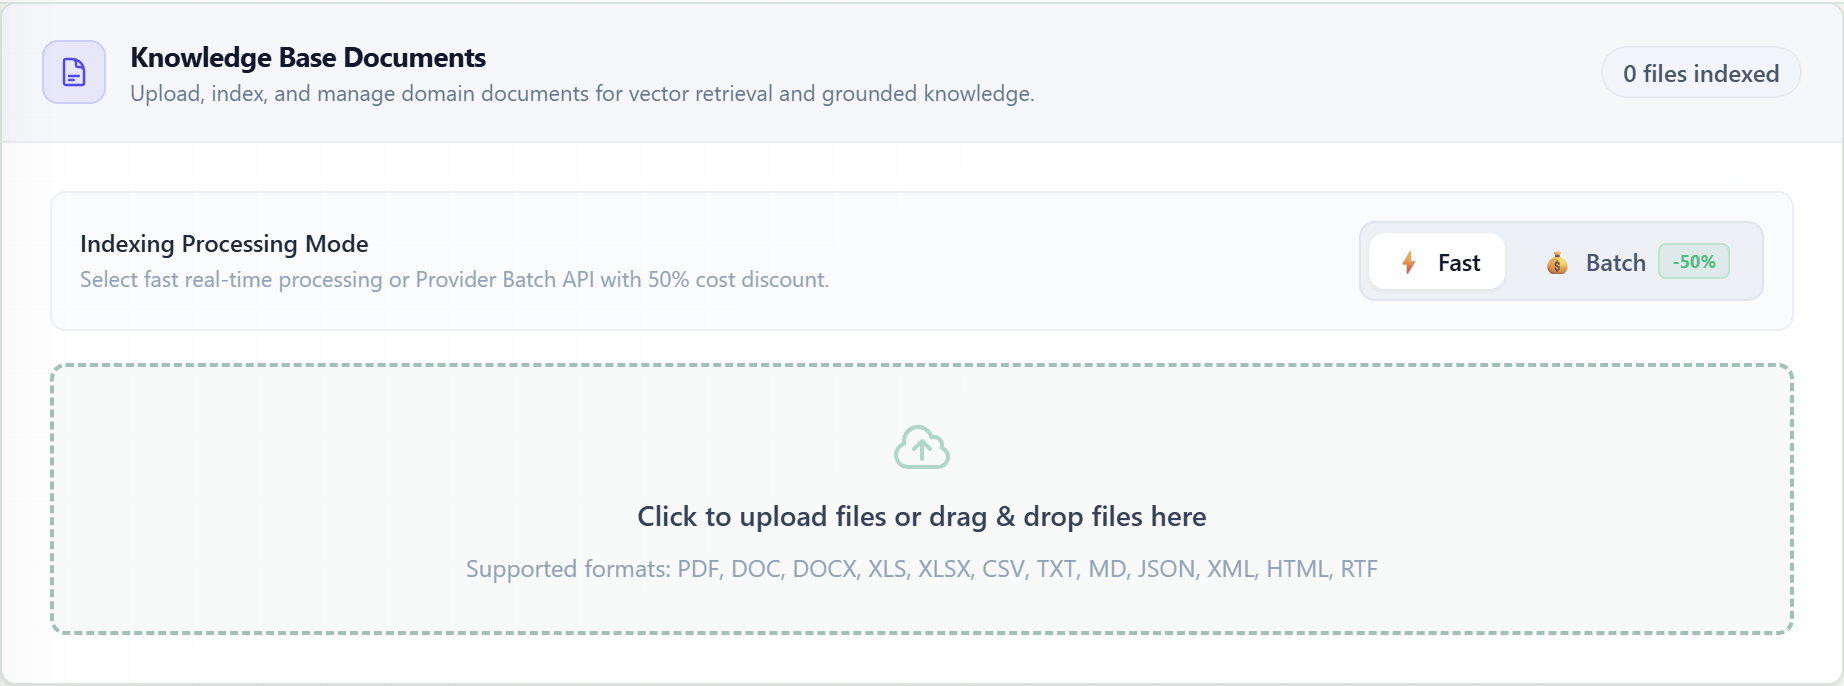
Alterar o modelo de incorporação ou a dimensão do vetor após a indexação pode exigir o reprocessamento dos documentos para que os vetores armazenados permaneçam compatíveis.
Step 02 · Section 09
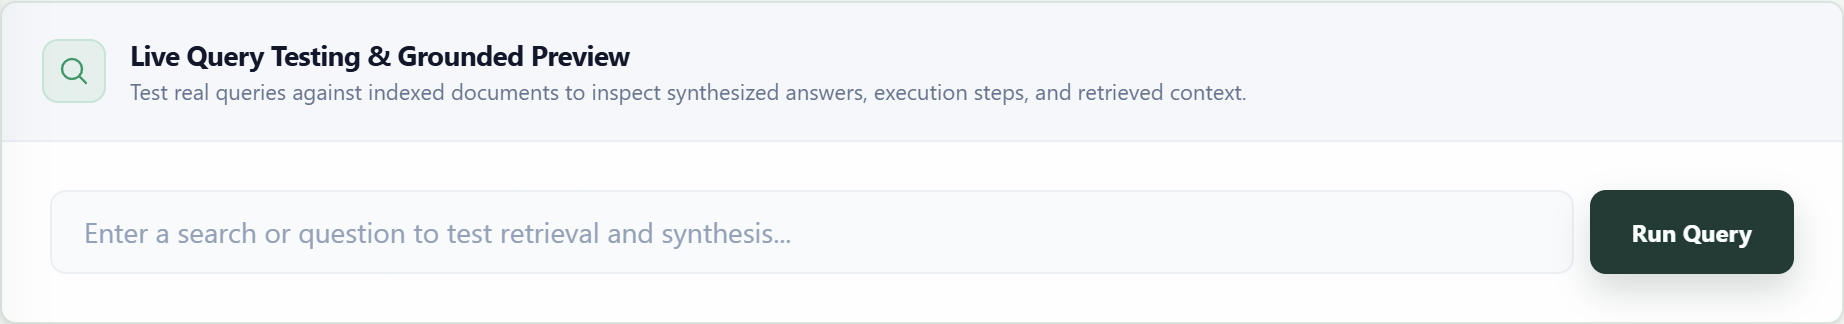
Teste de consulta ao vivo
Depois de salvar e indexar documentos, envie consultas representativas para inspecionar a resposta fundamentada, os pedaços recuperados, os fatos extraídos, as etapas de execução e o contexto montado.
Obrigatório antes de salvar
Padrão, nome RAG, modelo de incorporação, dimensão vetorial e todos os modelos exigidos pela arquitetura selecionada.
Após a criação
Use perguntas que exijam fatos exatos e síntese de múltiplas fontes e, em seguida, ajuste os limites de recuperação com base nas evidências retornadas.