
Ugruntuj każdą odpowiedź swoją wiedzę.
Wybierz architekturę wyszukiwania, skonfiguruj jej modele i ograniczenia wyszukiwania, a następnie zindeksuj dokumenty, na których powinny opierać się odpowiedzi.
Każdy RAG wymaga nazwy, modelu osadzania i wymiaru wektorowego. Modele grafów, routerów, wizji i syntezy pojawiają się tylko wtedy, gdy ich możliwości są włączone.
Przegląd
Zbuduj potok odzyskiwania
Konfiguracja RAG konwertuje dokumenty źródłowe na wektory i pobiera odpowiedni kontekst dla każdego zapytania. Bardziej zaawansowane wzorce dodają reranking, ekstrakcję wizualną, przeglądanie wykresów, wyszukiwanie leksykalne lub routing oparty na intencjach.
Wybierz strategię wyszukiwania dostosowaną do kształtu swojej wiedzy.
Wybierz modele, wymiary wektorów i parametry pobierania ograniczonego.
Przesyłaj dokumenty, czekaj na indeksowanie i sprawdzaj pobieranie za pomocą prawdziwych zapytań.
Step 01
Wybierz wzór RAG
Każdy wzorzec aktywuje inną ścieżkę wyszukiwania i w kroku drugim udostępnia tylko odpowiedni model i elementy sterujące dostrajaniem.
Bezpośrednie wyszukiwanie osadzania semantycznego, po którym następuje generowanie odpowiedzi na podstawie podstaw.
Pobiera szeroką pulę kandydatów, a następnie stosuje zmianę rankingu neuronowego, aby zachować najsilniejsze fragmenty.
Łączy wyszukiwanie tekstu z opisami wyodrębnionymi z obrazów, wykresów i diagramów.
Wyodrębnia jednostki i relacje, a następnie przechodzi przez wykres wiedzy w kontekście wielu przeskoków.
Łączy gęste podobieństwo wektorów z rzadkim dopasowywaniem słów kluczowych BM25 w celu zapewnienia zrównoważonego zapamiętywania.
Klasyfikuje każde zapytanie i kieruje je między wyszukiwaniem wektorowym, przeglądaniem wykresu lub odpowiedzią bezpośrednią.
Step 02 · Section 01
Szczegóły RAG
Zidentyfikuj bazę wiedzy i opisz dziedzinę objętą jej zindeksowanymi źródłami.
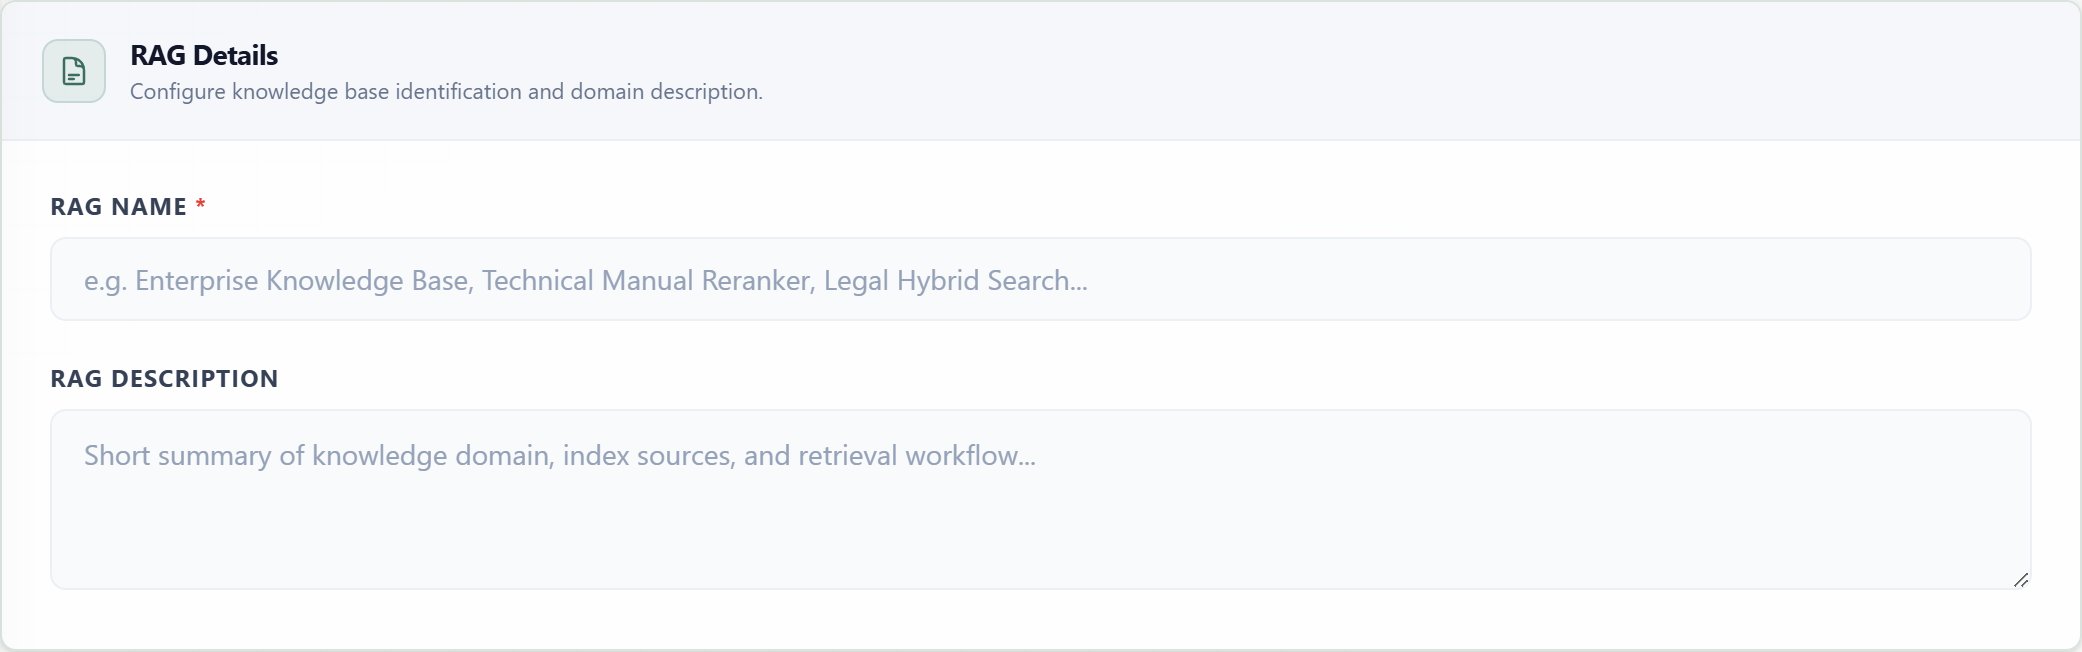
RAG NazwaDOCS.WYMAGANYNazwa wyświetlana używana w katalogach i selektorach RAG dla agentów, widżetów i obiektów docelowych API.
OpisDOCS.FAKULTATYWNYZwięzłe podsumowanie dziedziny wiedzy, materiału źródłowego i celu wyszukiwania.
Step 02 · Section 02
Model osadzania wektorowego
Model osadzania konwertuje fragmenty dokumentów i zapytania na wektory numeryczne. Wybrany wymiar ustala kształt wektora używany do indeksowania i wyszukiwania podobieństw.
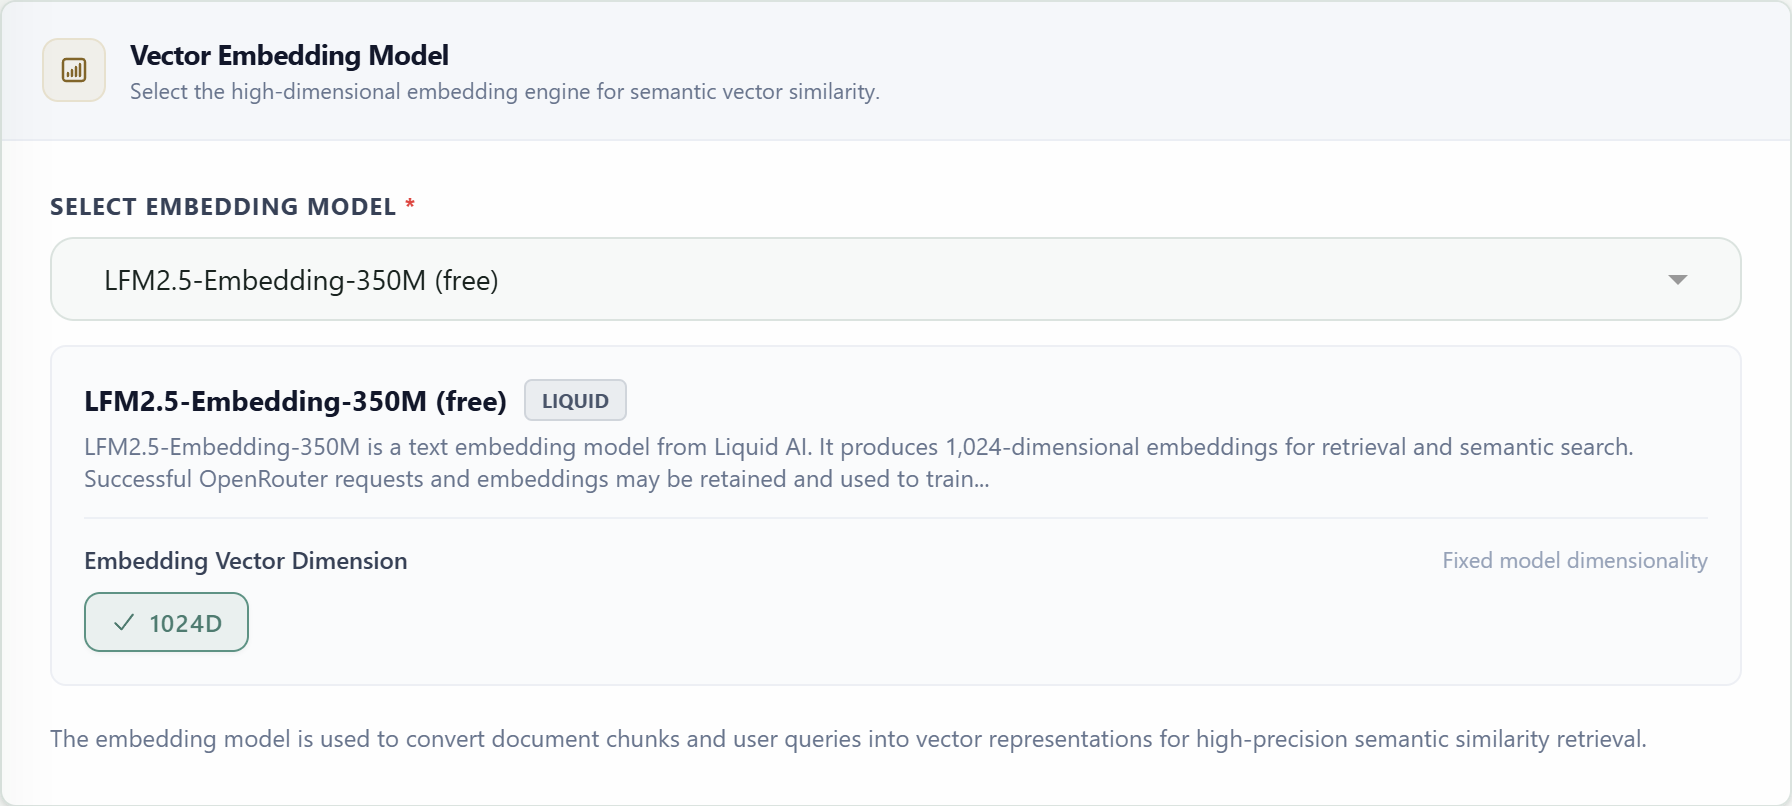
Model osadzaniaWymaganyWybiera model dostawcy używany do kodowania zarówno fragmentów dokumentu, jak i przychodzących zapytań.
Wymiar wektorowyWymaganyUstawia liczbę wartości numerycznych przechowywanych dla każdej reprezentacji wektorowej.
Step 02 · Section 03
Model AI do rerankingu
Model rerankingu wykorzystuje neuronowy cross-encoder do oceny każdego kandydującego fragmentu względem zapytania użytkownika po szerokim wyszukiwaniu wektorowym. Ponownie porządkuje kandydatów, aby końcowy kontekst zawierał najbardziej trafne fragmenty.
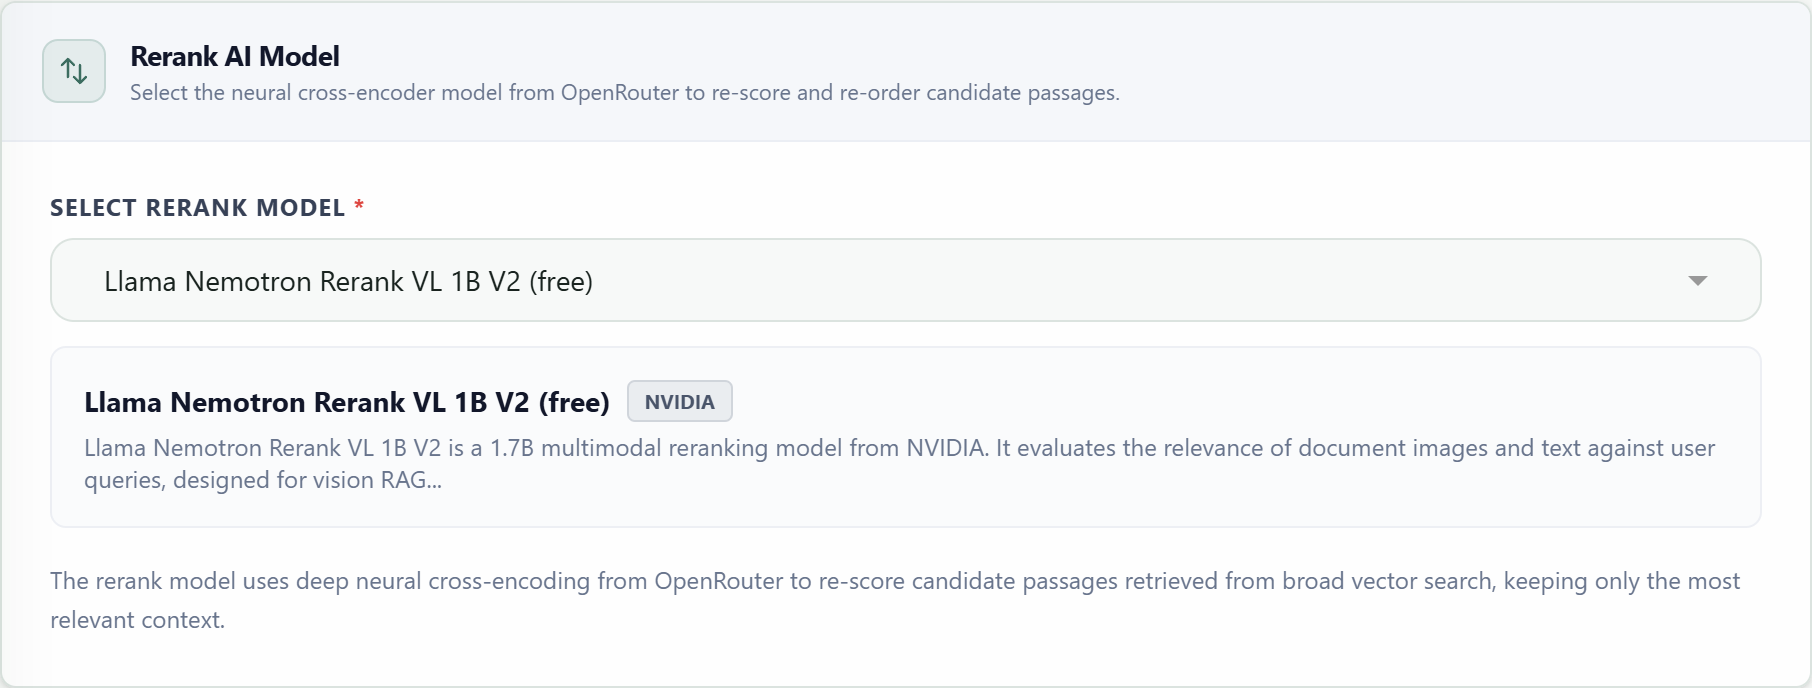
Model rerankinguWymaganyWybiera cross-encoder używany do oceny kandydatów wyszukiwania wektorowego dla każdego zapytania.
Step 02 · Sections 04–07
Specjalistyczne modele AI
Dodatkowe modele pojawiają się tylko wtedy, gdy wymaga ich architektura lub opcjonalna funkcja. Każdy zgodny model rozumowania może również po dokonaniu wyboru udostępnić selektor wysiłku.
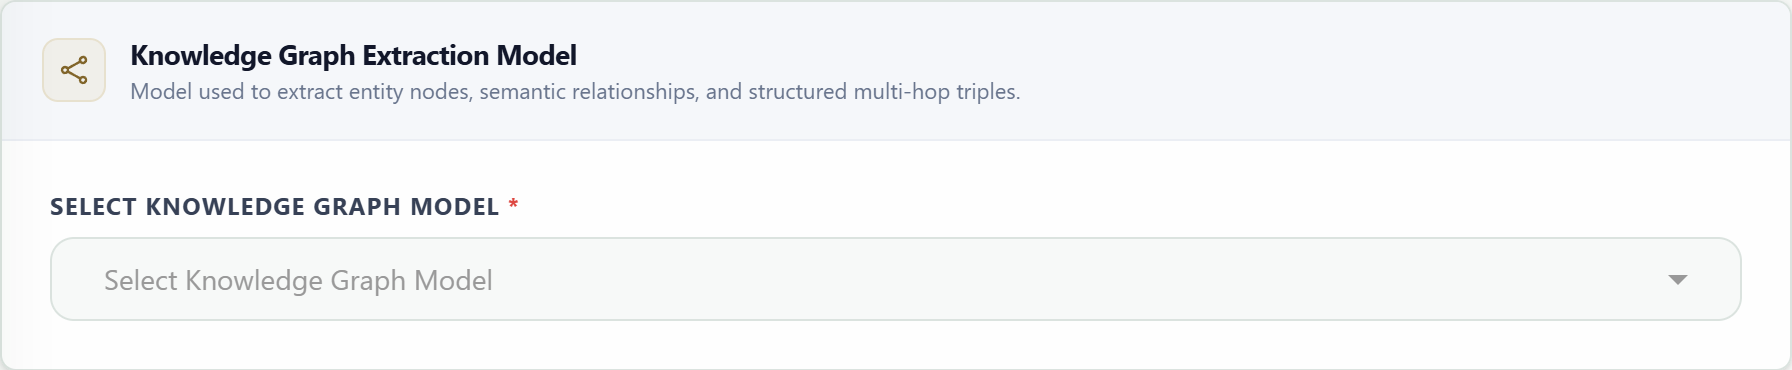
Model graficznyWarunkowyPodczas indeksowania wyodrębnia węzły jednostek, relacje semantyczne i ustrukturyzowane trójki.
Model routeraWarunkowyKlasyfikuje przychodzące zamiary i wybiera pobieranie wektorów, przeglądanie wykresu lub reakcję bezpośrednią.
Model wizjiWarunkowyOpisuje obrazy, wykresy i diagramy, dzięki czemu informacje wizualne mogą dołączyć do kontekstu, który można przeszukiwać.
Model odpowiedziWarunkowyZamienia odzyskane fragmenty w ugruntowaną konwersacyjną odpowiedź na samodzielne zapytania i widżety RAG.
Wysiłek rozumowaniaWarunkowyStosuje obsługiwany poziom wysiłku do modeli wykresów, routerów, wizji lub odpowiedzi.
TemperaturaWarunkowyKontroluje zmienność generowanej mocy dla odpowiednich etapów wytwarzania.
Step 02 · Section 08
Architektura i parametry wyszukiwania
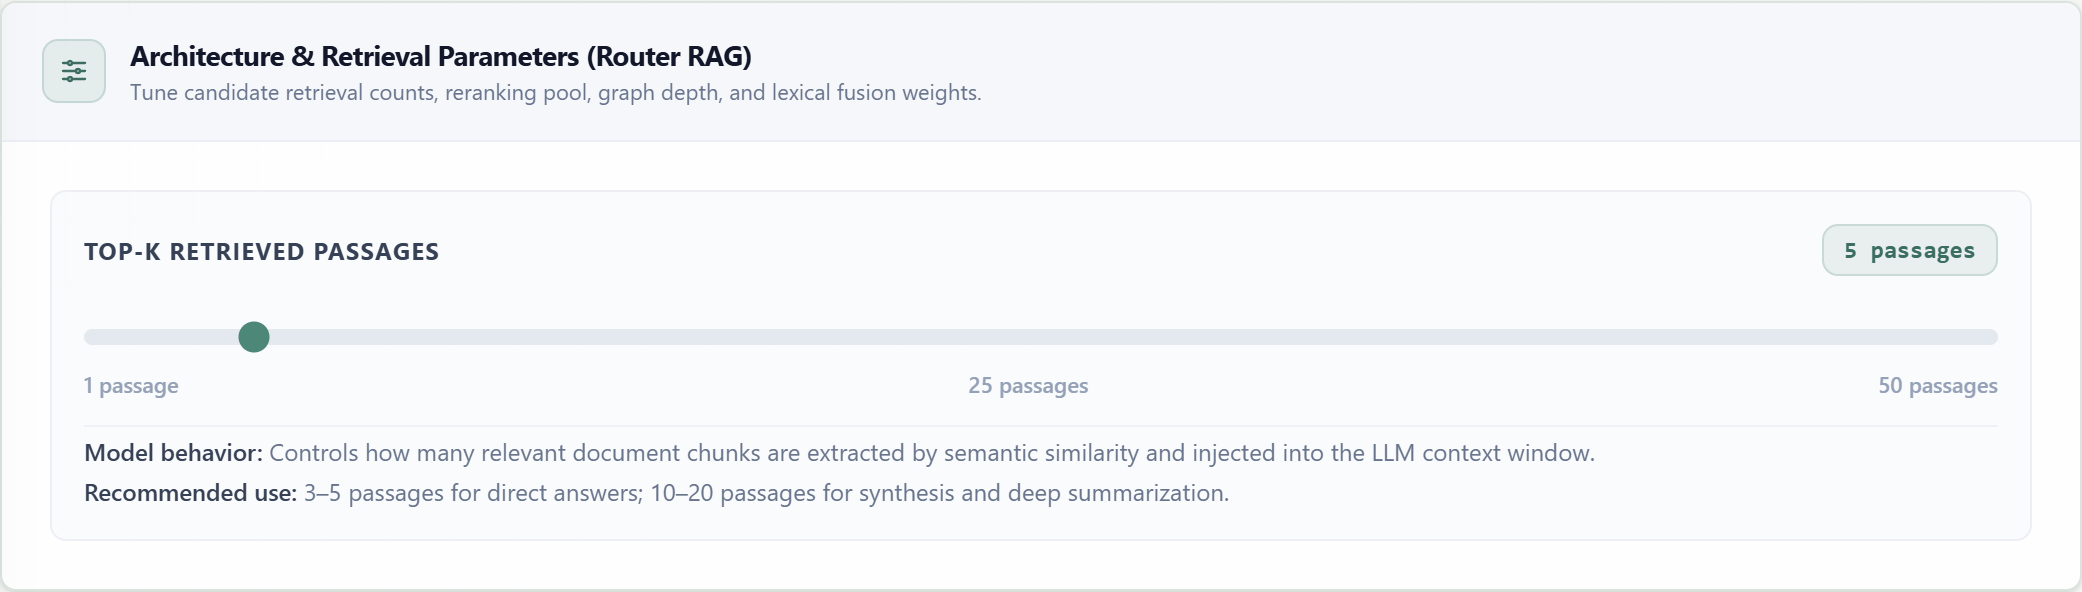
Suwaki kontrolują ilość kontekstu kandydata zbieranego na każdym etapie. Karta zmienia się wraz z wybranym wzorcem, dlatego wyświetlane są tylko parametry używane przez ten potok.
| Parametr | Wzór | Domyślne / Zakres | Zamiar |
|---|---|---|---|
| góra_k | Naiwny, multimodalny, router | 5 · 1–50 | Fragmenty wstawione w ostateczny kontekst. |
| inicjał_góra_k | Odzyskaj i ponownie uszereguj | 25 · 5–100 | Szeroka semantyczna pula kandydatów przed zmianą rankingu. |
| final_top_k | Zmień rangę, hybryda | 5 · 1–20 | Przejścia zachowane po zmianie rangi lub fuzji rang. |
| wektor_top_k | Wykres | 4 · 1–20 | Semantyczne fragmenty początkowe używane do lokalizowania elementów wykresu. |
| głębokość_grafu | Wykres | 1 · 1–3 | Przeskoki relacji przechodzą z jednostek źródłowych. |
| graph_limit | Wykres | 20 · 1–100 | Do kontekstu dodano maksymalną liczbę potrójnych relacji między jednostkami. |
| wektor_k | Hybrydowy | 15 · 1–50 | Gęste kandydaci semantyczni uwzględnieni w fuzji rang. |
| bm25_k | Hybrydowy | 15 · 1–50 | Rzadcy kandydaci leksykalni uwzględnieni w fuzji rang. |
Step 02 · Section 08
Dokumenty bazy wiedzy
Zapisz najpierw RAG, aby umożliwić przesyłanie dokumentów. Przesłane pliki są indeksowane według wybranego modelu osadzania i stają się dostępne do pobrania po zakończeniu przetwarzania.
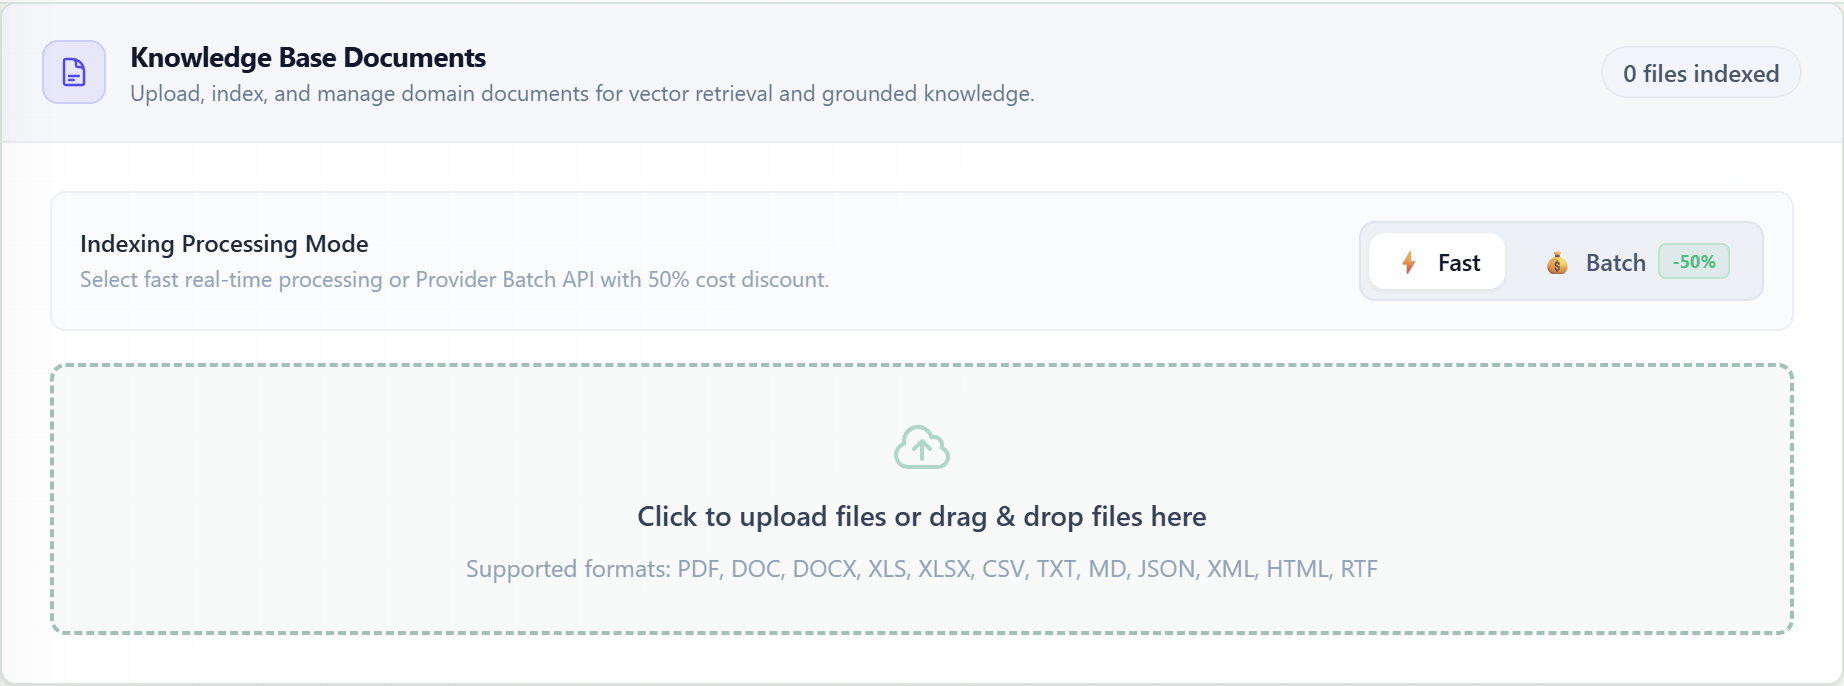
Zmiana modelu osadzania lub wymiaru wektora po indeksowaniu może wymagać ponownego przetworzenia dokumentów, aby przechowywane wektory pozostały kompatybilne.
Step 02 · Section 09
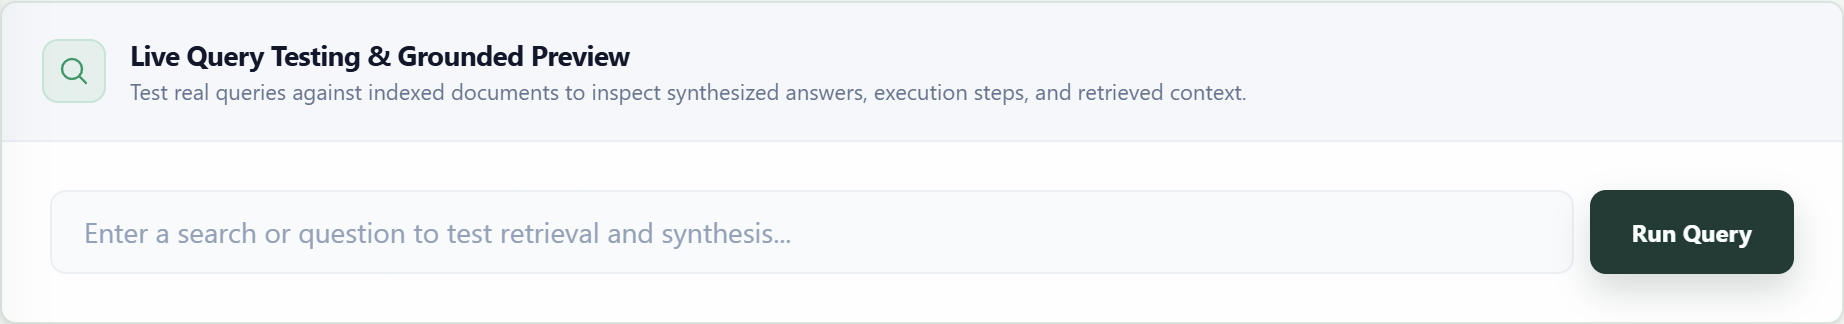
Testowanie zapytań na żywo
Po zapisaniu i zindeksowaniu dokumentów prześlij reprezentatywne zapytania, aby sprawdzić ugruntowaną odpowiedź, pobrane fragmenty, wyodrębnione fakty, etapy wykonania i złożony kontekst.
Wymagane przed zapisaniem
Wzorzec, nazwa RAG, model osadzania, wymiar wektorowy i każdy model wymagany przez wybraną architekturę.
Po stworzeniu
Używaj pytań wymagających dokładnych faktów i syntezy z wielu źródeł, a następnie dostosuj limity wyszukiwania na podstawie zwróconych dowodów.